
RAG・追加学習・長文入力は、資料の渡し方と答え方の調整を分けて選びます。少数の対象資料をまとめて渡すなら長文入力、質問に応じて資料を探して渡すならRAG、繰り返すタスクの出力傾向を調整するなら追加学習が候補です。
約10分で読めます
「知識が足りない」と「答え方が違う」は別。RAG・追加学習・長文入力の選び方
長い資料を渡す、必要な箇所を検索する、追加学習する。規程案内の3例でそれぞれの役割を比較し、資料の更新や読む人の権限に合う方法を選びます。判断表と編集できる記入票付き。
影山 湧亮 / NeoLogic株式会社 代表取締役。元警視庁。現場業務の整理と生成AI活用・Webシステム開発を一貫して担当。
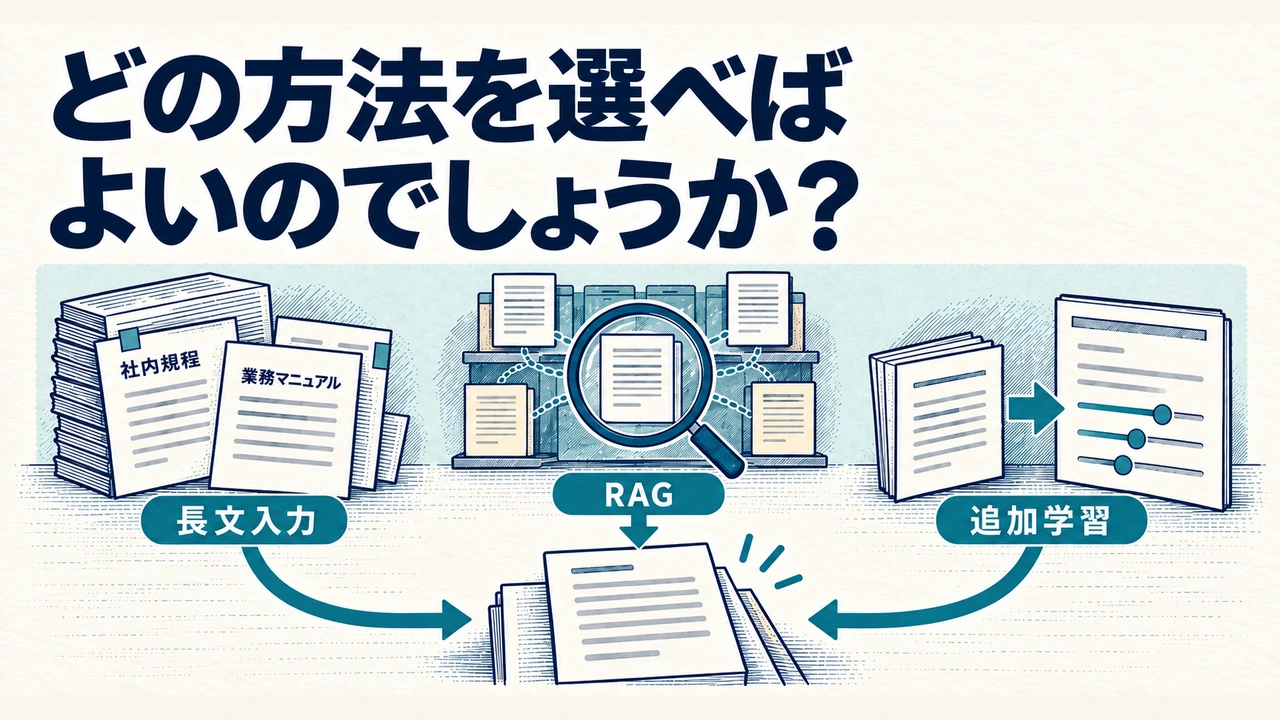
たとえば「出張の申請方法をAIに答えさせたい。規程を全部読ませればよいのか、それとも社内専用に学習させるのか」。この相談では、必要な資料を渡すことと、望む答え方に近づけることが混ざりやすくなります。
三つは役割が異なるため、併用もできます(出典:OpenAI「Model optimization」、OpenAI「Optimizing LLM Accuracy」)。
三方式は、資料とモデルのどこを変えるのか
長文入力とRAGは、主に回答時の材料の用意のしかたです。追加学習は、学習によってモデル側の振る舞いを変える手段です。役割の違う構成要素として見てください。会話の記憶やメモリ機能まで含めた違いは、AIが会話や資料をどう覚えるかで整理しています。
長文入力:対象資料をまとめて渡す
質問に必要な資料を特定できているなら、その本文を質問や指示と一緒に入力します。検索基盤を追加せず試せる点が出発点になります。長文入力にも上限があります。入力と出力に加え、モデルによっては内部で考えるための容量も同じ枠を使います。資料だけで上限を使い切らない設計が必要です。
資料名・版・該当箇所も付け、回答から原文を確認できるようにします。ファイル添付型の製品が内部で全文入力と検索のどちらを使うかは、その製品の仕様で異なります。ここでいう長文入力は、対象本文を回答時の入力へまとめて入れる構成を指します(出典:OpenAI「Conversation state」)。
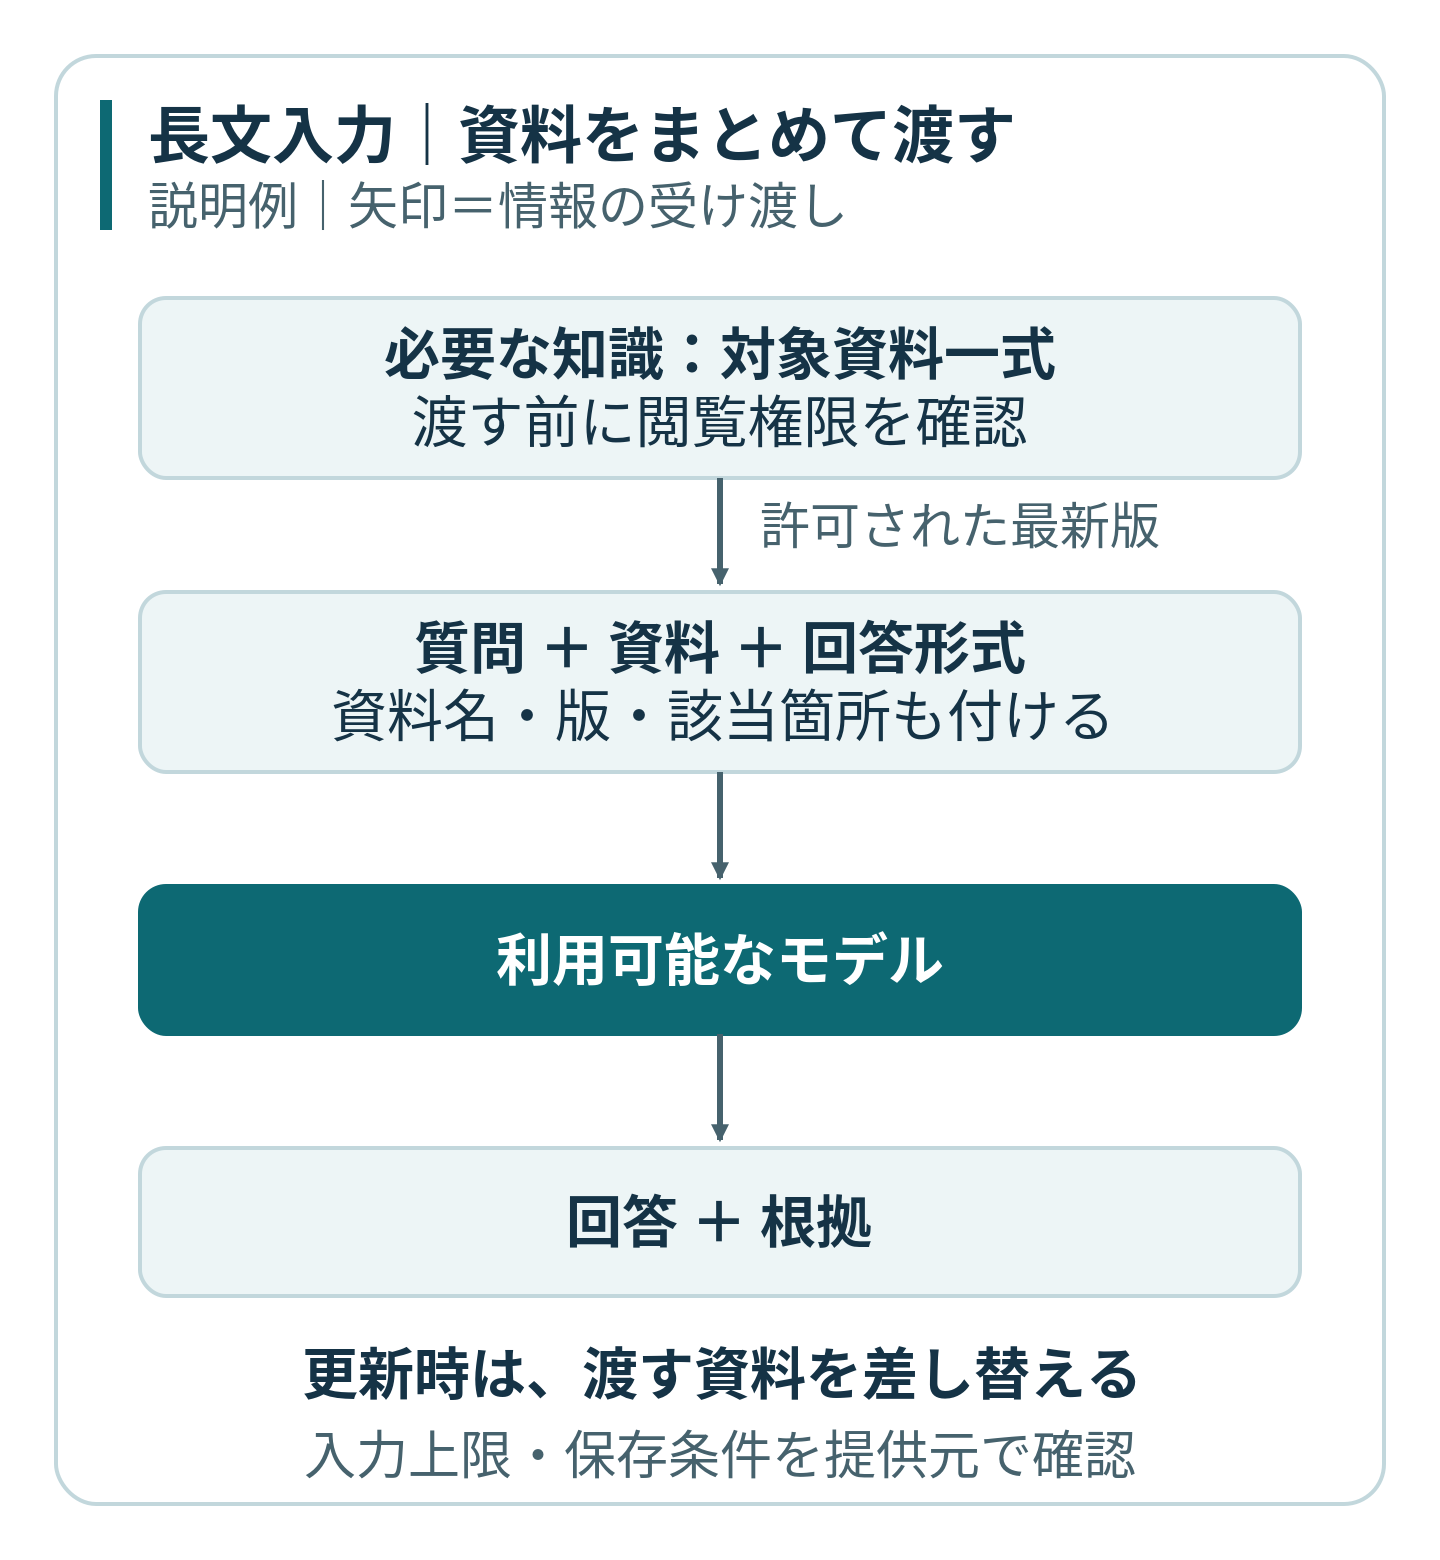
図1a 長文入力:許可された資料を、質問・回答形式と一緒に渡します。
RAG:関係する資料を検索してから渡す
RAG(検索拡張生成)は、質問に関係する情報を検索し、その結果を材料に回答を生成する構成です。多数の資料を保管していても、一回答に全部を入れる必要はありません。一方、検索に漏れた条件や例外は、回答の材料からも落ちます。
更新される資料では、正本の変更を検索対象へ反映し、古い版や削除済みの文書をどう扱うか決めます。権限も検索時に適用します。「回答に書かないで」という指示だけに頼らず、許可されない本文を生成モデルへ渡さない構成にします。引用リンクの閲覧権限も別に確認します(出典:OpenAI「Retrieval」、Microsoft「Retrieval augmented generation (RAG) and indexes in Microsoft Foundry」)。
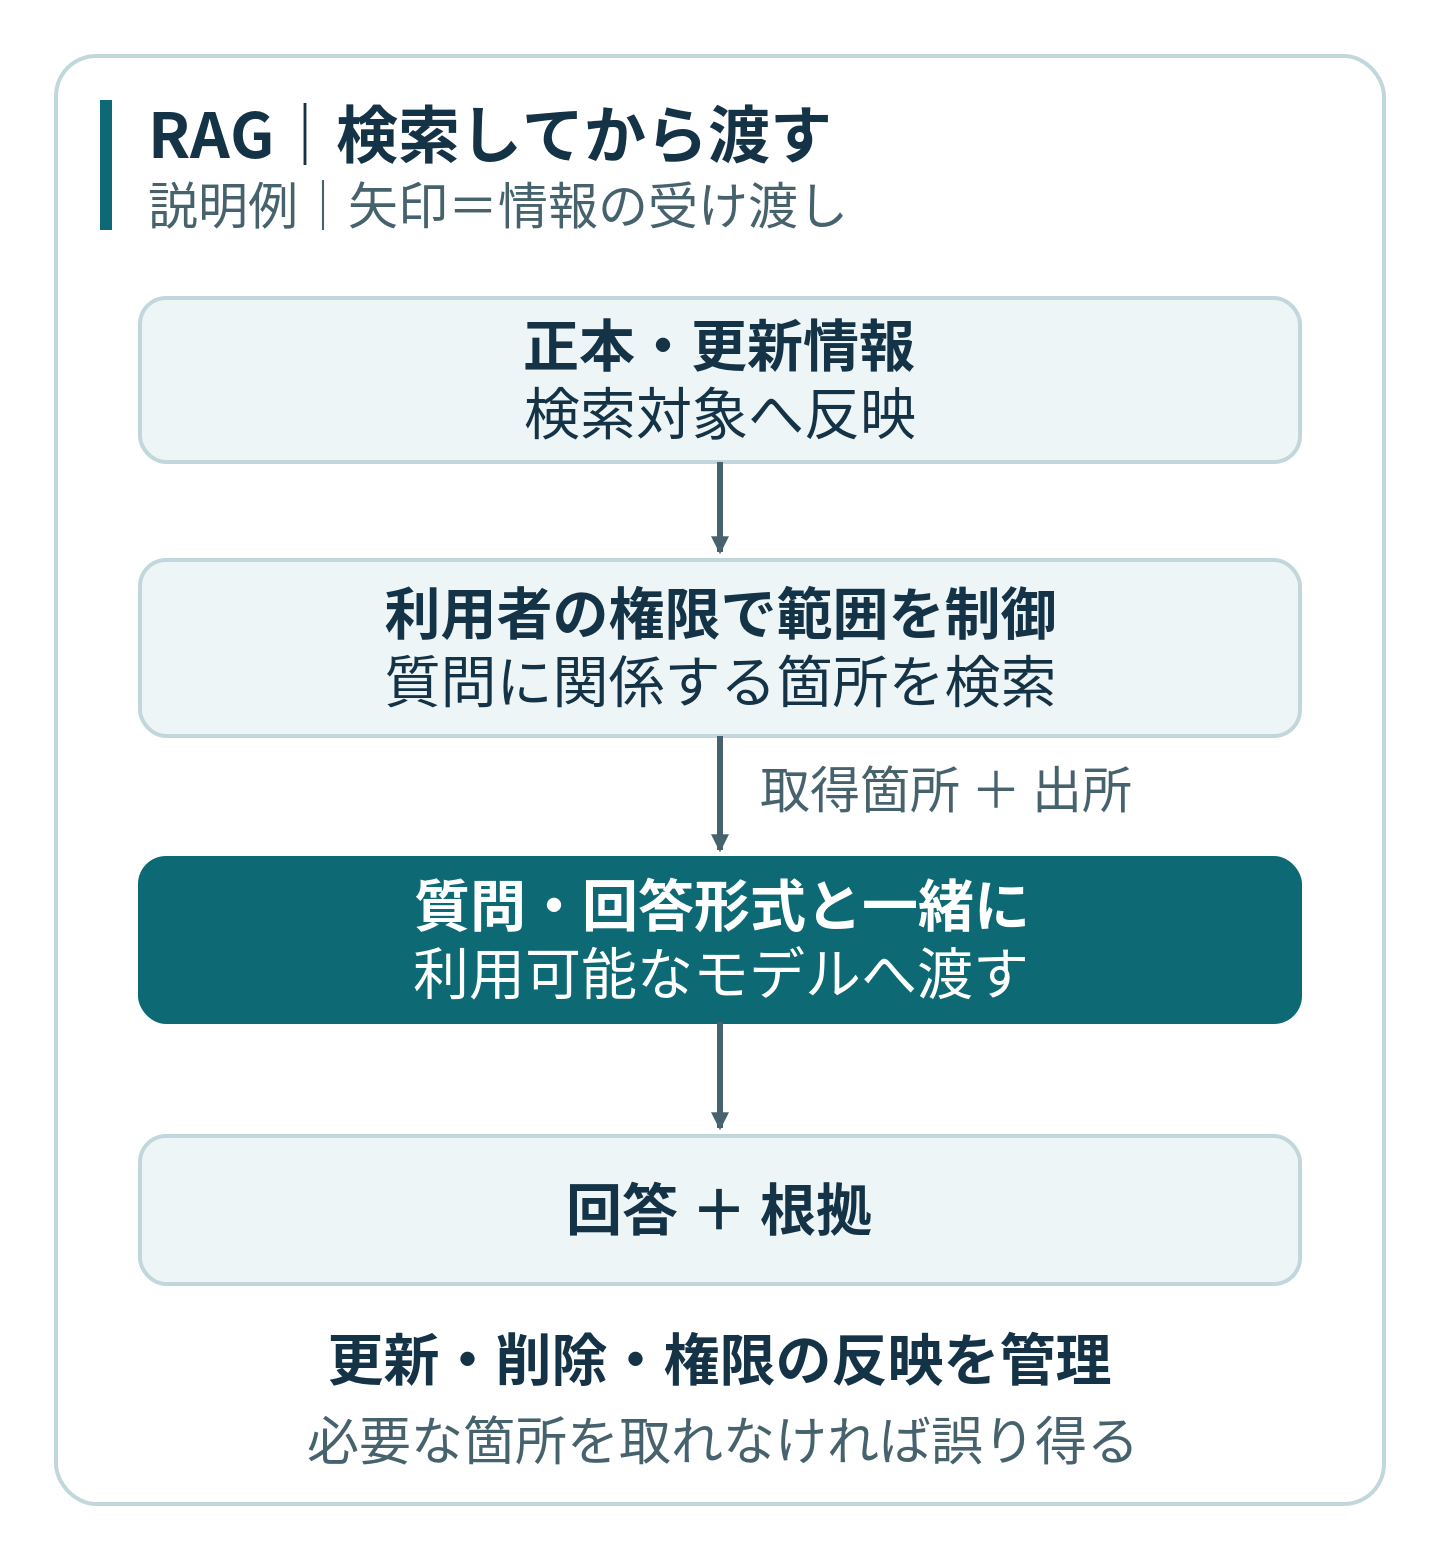
図1b RAG:利用者に許可された範囲から検索し、必要な箇所を渡します。
追加学習:学習例から出力傾向を調整する
追加学習(ファインチューニング)は、学習済みモデルを、用意したデータで特定のタスクへ調整する方法です。ここでは主に、入力と望ましい出力の例を用意する教師あり追加学習を念頭に置きます。口調や分類、繰り返す出力の傾向などが検討対象になります。
追加学習では事実を含むタスクの例も使えます。ただし、最新版の条文、回答ごとの根拠、利用者ごとの閲覧範囲には、それぞれの管理が必要です。更新・権限・根拠を必要とする業務では、追加学習だけで置き換えず、回答時に資料を渡す仕組みを残す判断になります(出典:OpenAI「Model optimization」、Microsoft「Retrieval augmented generation (RAG) and indexes in Microsoft Foundry」)。
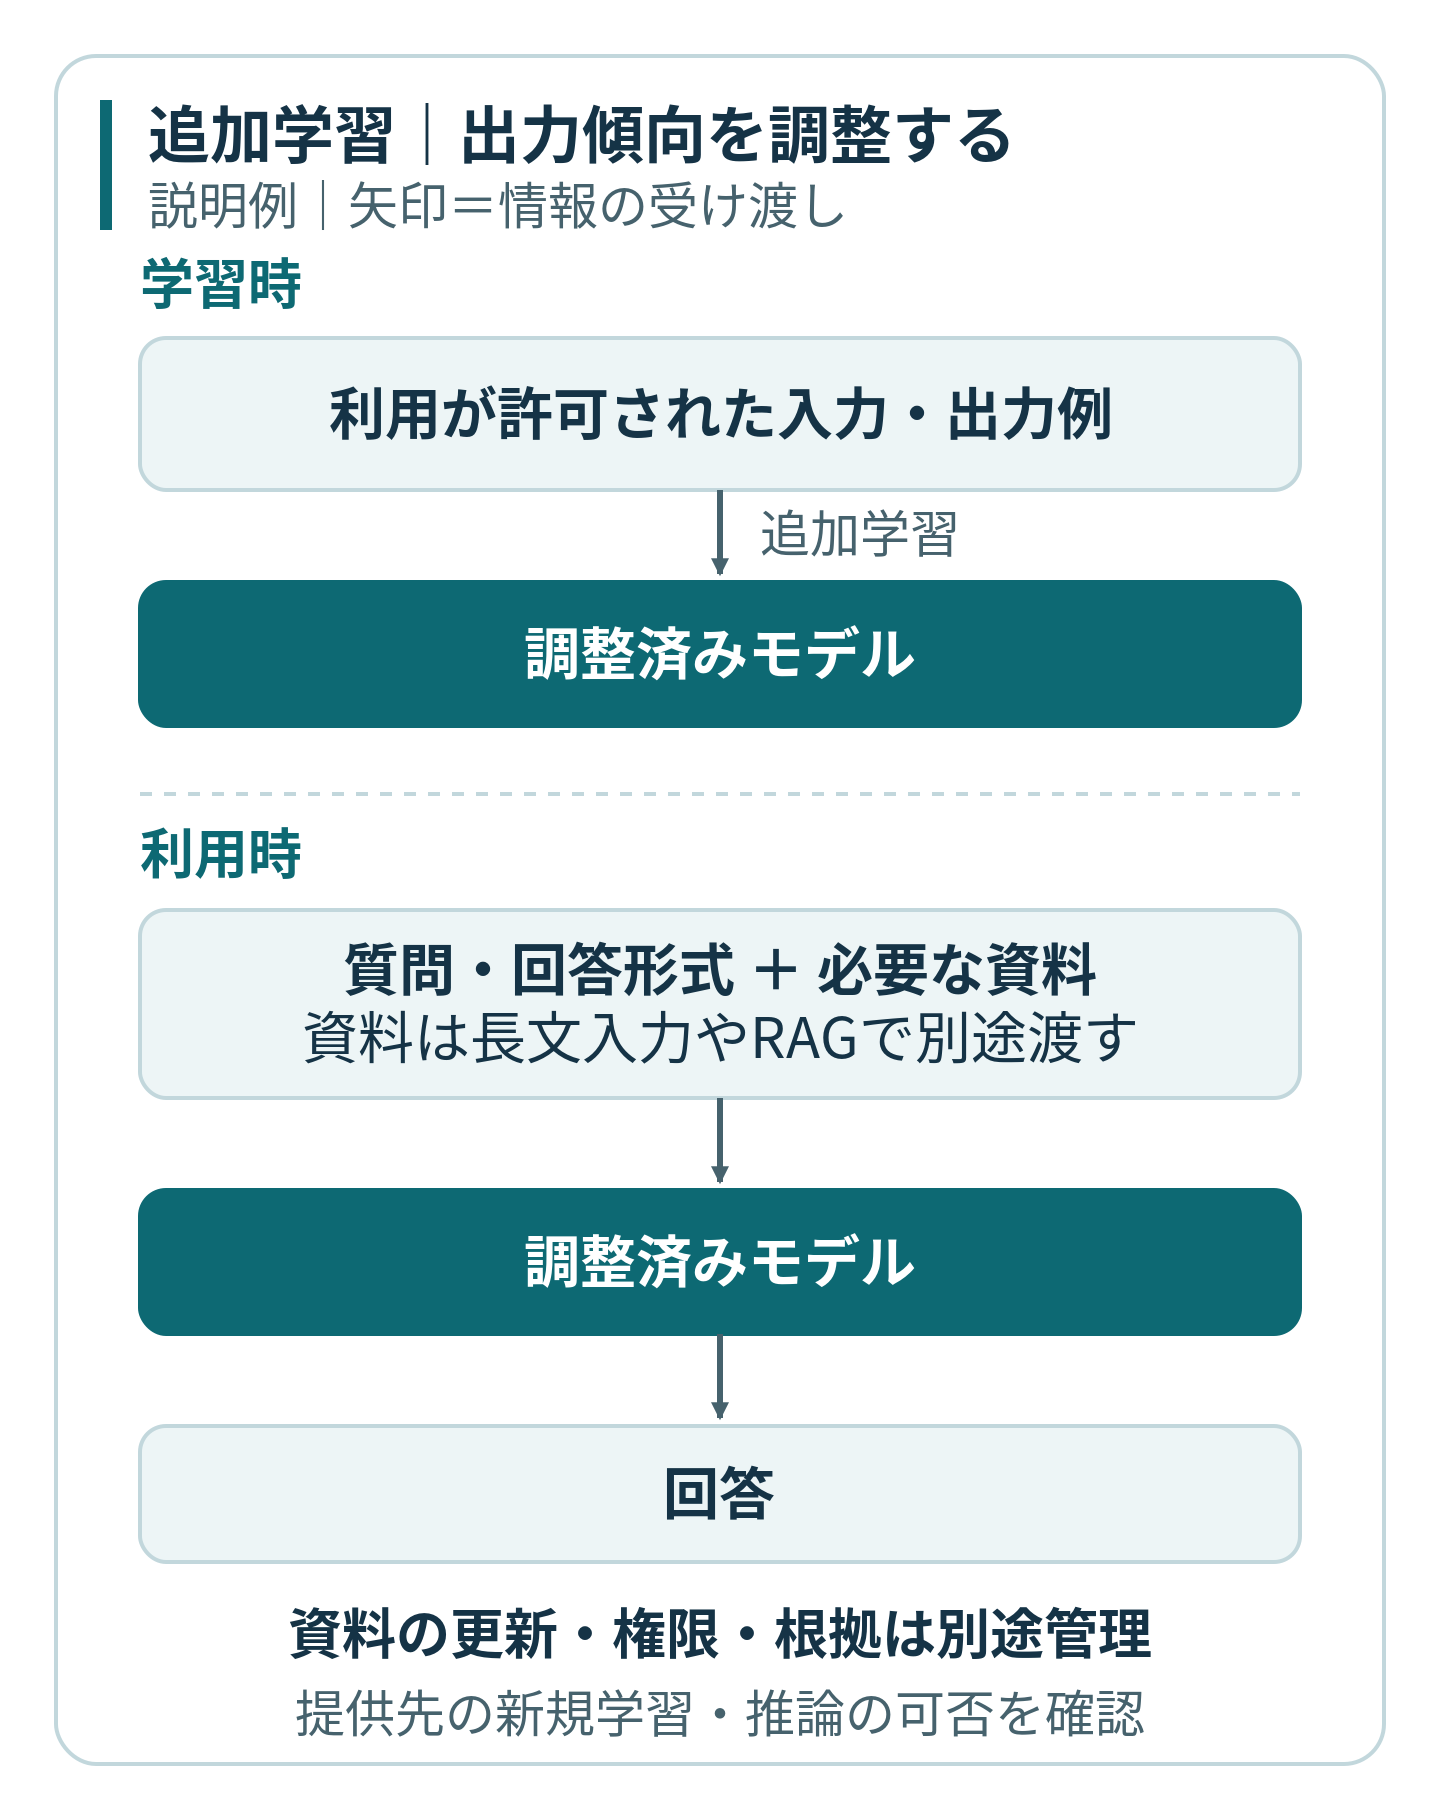
図1c 追加学習:学習時にモデルを調整し、利用時はそのモデルへ入力します。
回答形式と根拠表示は各構成で設計し、利用可能な提供先・モデルは実装前に調べます。
「知識が足りない」と「答え方が違う」を分ける
最初に、「何を知らないのか」を質問と資料の組で書き出します。自社の提出先や添付書類が必要なら、その正本がどこにあるかを確かめます。必要な知識が曖昧なままでは、資料を追加すべきか、探し方を直すべきかを決められません。
「出張申請の提出先と必要書類は?」への下書きを比べます(想定例)。
| 下書きに起きたこと | 先に調べること |
|---|---|
| 「上司に相談してください」とだけ答え、規程にある提出先と添付書類が出ない | 必要な規程が渡っているか、該当箇所を取得できたか |
| 提出先と書類は合っているが、指定した「結論/条件・例外/根拠」に分かれない | 指示と見本、形式を指定する機能で直せるか |
資料を渡していないなら、まず入力に含めます。資料はあるのに該当箇所を探せないなら、検索や資料の整理が検討対象です。正しい根拠を渡しても指示どおりに答えないなら、指示、見本、モデルの選択を見直します。形式だけが不安定なら、内容の不足とは分けて扱います。
資料2件の場合と、部署ごとに見せる資料が違う場合
「みなと機器社」の出張規程を使い、資料と権限の条件を変えてみます(想定例)。どの不足を解決するために方式を選ぶのかを比べてください。
同じ出張規程の案内でも、対象量・更新・権限・答え方によって最初に試す方法が変わります。
三つの条件で変わる選択
| 前提 | 試す構成 | 成立条件・再検討の理由 |
|---|---|---|
| A:資料2件・計8ページ/四半期更新/全社員共通 | 長文入力から試す | 入力枠に収まり、根拠を追えること。毎日更新でも差し替えを確実に行えるなら候補に残る |
| B:資料12件・計60ページ/月次更新/部署別の閲覧範囲 | 権限制御付きRAGを第一候補にする | 量だけでなく、質問ごとの選別と権限・更新管理が理由。長文入力でも同条件を満たすなら比較する |
| C:Bと同じ資料・更新・権限/回答形式だけ不安定 | まず指示・見本・形式制約を改善する | 残る振る舞いの問題と良質な学習例がそろった場合に限り、RAG+追加学習を比較する |
回答形式が課題なら、項目名と正しい回答例を指示へ加えるところから始めます。JSONなど機械処理用の形式が必要なら、対応モデルの構造化出力も候補です。回答形式と内容の正しさをそれぞれ確認し、拒否や途中終了も処理します。追加学習は、その対策後にも残る振る舞いの問題に対して検討します(出典:OpenAI「Structured model outputs」)。
反対に、どの規程が正本か分からず、誰に見せてよいかも未確定なら、三方式の選択より先に資料管理者に聞きます。総務から正本と施行日、各部署の責任者から閲覧範囲を得る想定です。資料にない社内判断を推測して確定させる使い方は対象外とし、確認先へ案内します。
RAGと追加学習を併用する場合も、検索で最新の材料を渡す役割と、回答の振る舞いを調整する役割を分けます。両方を入れること自体を目的にせず、片方で条件を満たすなら、それ以上の構成は採らない判断もできます(出典:OpenAI「Optimizing LLM Accuracy」)。
部署別に検索する案の記入済み見本
部署別に検索する場合の記入例
| 記入項目 | 記入済み見本 |
|---|---|
| 対象業務・必要な知識 | 「みなと機器社」で、出張申請の提出先と必要書類を答える。規程本文と申請手順を使う。 |
| 資料量・更新頻度 | 資料12件、計60ページ。月次改定。総務担当が正本と施行日を管理する想定。 |
| 回答形式 | 「結論/条件・例外/根拠(文書名・版・条番号)」の3項目。不足時は推測せず問い合わせ先を案内する。 |
| 根拠と権限 | 一般規程は全社員、部署別付則は該当部署のみ。質問時の権限で検索対象を絞り、引用先にも同じ制御を適用する。 |
| 採用候補と理由 | 権限制御付きRAG。質問に必要な最新版を、部署ごとに取り出すため。長文入力とも同じ質問で比べる。 |
| 非採用・併用 | 追加学習だけで規程を覚えさせる案は採らない。長文入力は比較候補に残し、回答形式はまず指示と見本で整える。 |
| 利用可能な提供先 | 提供元・モデル・リージョンは未選定。OpenAIの新規セルフサービス追加学習を前提にしない。 |
| 記入日・版 | 2026-09-15/想定例v1.0。 |
| 次に調べること | 正本・施行日・権限が不明なら先に資料管理者へ聞く。正答率、応答時間、利用費、入力枠への適合は試用で測る。 |
提供元ごとの利用条件・終了予定(2026年9月17日確認)
2026年9月17日に再確認したOpenAI公式の廃止案内では、セルフサービス追加学習は段階的に制限されています。2026年5月7日以降、過去に追加学習を実行していない組織は学習・ジョブ作成を利用できません。7月2日以降は、過去60日以内に追加学習済みモデルで推論していない組織も、新規ジョブを作成できません。
アクティブな既存利用者も、2027年1月6日には新規ジョブを作成できなくなる予定です。一方、追加学習済みモデルの推論は、基盤モデルが廃止されるまで継続するとの案内です。全モデルの推論が同日に停止する意味ではありません。新規構築では、この追加学習基盤を前提にせず候補を選びます(出典:OpenAI「Deprecations」)。
これは追加学習という技術全体や、他社の提供終了を意味しません。Google Cloudの現行公式資料には、Geminiの教師あり追加学習の対象モデルとジョブ作成手順があります。ただし、その記載だけで自社が使えるとは確定しません。モデル、リージョン、契約、利用権限、終了予定を提供元ごとに確認します(出典:Google Cloud「Tune Gemini models with supervised fine-tuning」)。
方式を選んだら、速度と運用費を比べる
A・B・Cで選んだ候補を、同じ質問・正本・利用者の権限で比較します。資料と回答形式の条件に加え、次の速度・費用・保守を見ます。
表1 同じ品質を満たした候補で比べる速度・費用・保守
| 比較軸 | 長文入力 | RAG | 追加学習 |
|---|---|---|---|
| 速度 | 入力の長さと生成量を測る | 検索時間と生成時間を合わせて測る | 実際のモデル・入力で測る。学習時間とは分ける |
| 利用費 | 入力・出力、キャッシュ条件を調べる | 検索・保存・索引更新と生成を合算する | 学習・推論とデータ整備・再評価を分ける |
| 保守 | 資料の差し替えと入力枠の管理 | 同期、検索設定、削除・権限の検証 | 学習データとモデルの版、再学習、移行の管理 |
資料の渡し方とモデル調整の違いは、OpenAIのモデル最適化とMicrosoftのRAG解説を参考にしています。
比較に使う費用は、同じ期間・質問数・回答品質でそろえます。推論料金だけでなく、資料の整備、検索対象の更新、学習例の作成、再評価も別欄にします。キャッシュの有無や検索工程で結果は変わるため、「RAGは常に安い」「追加学習なら必ず速い」とは決めません。
同じ質問と根拠で、候補を試す
比較前に、回答に含める条件と参照すべき正本を用意します。通常の質問だけでなく、例外条項が必要な質問、資料に答えがない質問、権限のない利用者からの質問を含めます。同じ質問・資料版・権限で、長文入力とRAGなど候補を試し、回答、根拠、形式、応答時間、利用費を別々に記録します。
追加学習も試す場合は、学習に使った例をそのまま比較問題にせず、別の評価例を用意します。品質の合格条件を決め、その範囲で費用と速度を比べます。応答時間や予算の上限が厳しい業務なら、それを先に候補条件へ入れます(出典:OpenAI「Model optimization」、OpenAI「Model selection」)。
まず、よくある質問を一つと、その答えが載る資料を用意してください。「誰が更新し、誰が読めて、何を根拠として返すか」も書き添えます。提供元の公式資料で新規利用可否とモデル上限を確認し、方式選択の記入票(XLSX)へ条件と未確認事項を記入すれば、比較や発注の出発点をそろえられます。
資料の置き場や名前を整える段階なら、社内検索AIの資料整理|更新・廃止・閲覧権限へ進んでください。構成候補を決めた後の詳しい確認方法は、RAGの評価方法|資料どおりでも足りない答えを探すで扱っています。
検索の改善が目的なら、既存検索の整備や社内製品の機能で足りるかも同じ質問で試せます(社内検索にAIは必要?既存検索と独自検索の比較)。
参考出典
- OpenAI「Model optimization」
- OpenAI「Conversation state」
- OpenAI「Optimizing LLM Accuracy」
- OpenAI「Retrieval」
- OpenAI「Structured model outputs」
- OpenAI「Model selection」
- OpenAI「Deprecations」
- Microsoft「Retrieval augmented generation (RAG) and indexes in Microsoft Foundry」
- Google Cloud「Tune Gemini models with supervised fine-tuning」
あわせて読む
規程を変えたのに、社内検索AIは古い期限を答える。資料の更新・廃止・権限の整え方
更新した規程が検索に出ない、廃止した資料から回答される。経費精算の例で、資料の置き場、更新日、管理担当、見られる人を整理します。変更後の検索と回答を試し、古い情報が残った場所を調べられます。
資料どおりに答えたのに、答えが足りない。RAGの評価で見落とす回答
社内資料を引用した答えでも、必要な条件が抜けていることがあります。検索、回答、引用、閲覧権限、答えを止める条件を別々に評価。期待結果の見本とExcel評価票で、不十分な回答を見つけられます。