
AIに資料を渡すことと、AIそのものを学習させることは別です。前の資料を参照できないときや、古い答えが返るときは、今回の回答にどの情報が渡ったかを調べます。学習・会話・メモリー・検索の違いが分かると、資料を渡し直すのか、設定や検索先を直すのかを選べます。
約10分で読めます
AIに資料を渡すことと、追加学習は別。古い答えが返ってくる理由
資料を渡したのに覚えていない、最新版があるのに古い答えが返る。学習・会話・メモリー・検索の違いを、旧版と新版の就業規程で比べます。回答の出典と参照した版をたどると、対処する場所が分かります。
影山 湧亮 / NeoLogic株式会社 代表取締役。元警視庁。現場業務の整理と生成AI活用・Webシステム開発を一貫して担当。
モデルの学習、会話内参照、保存メモリ、外部資料の検索は、それぞれ情報の扱い方が違います。資料の保存や添付だけで、モデルが学習したとは判断できません。一方、入力内容が後日の学習に使われるかは、製品・契約・設定によって変わります。OpenAIの会話状態の説明とデータの学習利用方針も、この二つを分けて読む必要があります。
| 困っていること | 最初に見る場所 |
|---|---|
| 別のチャットで、前に渡した資料を参照できない | 今回のチャットに資料があるか。過去の会話やファイルを使える設定か |
| 新版を渡したのに旧版の答えが出る | 回答の出典が指す版と施行日。新版が実際の検索結果に入っているか |
新版だけあれば、三つの質問に答えられるか
以下は架空の説明例です。ある会社の就業規程第12条は、旧版v1では在宅勤務が週1日まで、新版v2では週2日までとします。旧版は2026年3月31日まで、新版は4月1日から有効です。
| 質問 | 必要な資料 | この例で確かめる答え |
|---|---|---|
| 2026年9月15日時点で、在宅勤務は週何日まで? | 新版v2の第12条 | 週2日まで |
| 2026年3月時点では何日までだった? | 旧版v1の第12条 | 週1日まで |
| 4月1日に何が変わった? | 旧版と新版の第12条・施行日 | 上限が週1日から週2日になった |
同じ規程でも、聞きたい時点が違えば参照する版も変わります。「古い資料を全部消す」だけでは、過去の制度を尋ねる質問に答えられなくなります。
一度だけ改定箇所を比べるなら、対象資料を明示する
この例では、旧版と新版を両方添付し、比較対象と条文を指定する方法をまず選びます。必要なのは両版の差分であり、新版だけを検索対象にすると目的を満たせないからです。たとえば次のように依頼します。
添付の就業規程v1とv2の第12条を比較してください。旧版と新版の内容、施行日、変更点を分け、各記述の根拠を示してください。資料で確認できない条件は補わず「記載なし」としてください。
添付は利用者の操作、検索は情報を取り出す仕組みです。添付資料を内部で検索する製品もあるため、両者は併用できます。添付したという事実だけで、全文が渡されるか、必要な箇所が検索されるかは決めつけません。OpenAI APIのFile searchも、登録済みファイルから必要な情報を取得する機能です。
更新される規程へ繰り返し質問するなら、参照する版を整える
日常の問い合わせに使う場合は、質問の基準日に有効で、その人が閲覧できる規程を検索して渡す構成を検討します。2026年9月15日の制度を聞くなら、この例では新版v2の第12条が参照対象です。旧版も保存できますが、現在の制度への回答とは分けます。
検索には、資料の更新、施行日や版の条件、閲覧権限の確認が必要です。OpenAIの検索機能には、資料に付けた日付などで対象を絞る方法があります。ただし、質問者が閲覧できる資料だけを渡す処理は、別途設計する必要があります。検索(RAG)・追加学習・長文入力のどれで資料を渡すかは、AIに知識を渡す方法の比較で選び方を説明しています。
資料が少なく更新もまれなら、管理担当者が正式な版を確認して都度添付する方が運用しやすい場合もあります。資料の量や更新頻度に合わせて選んでください。
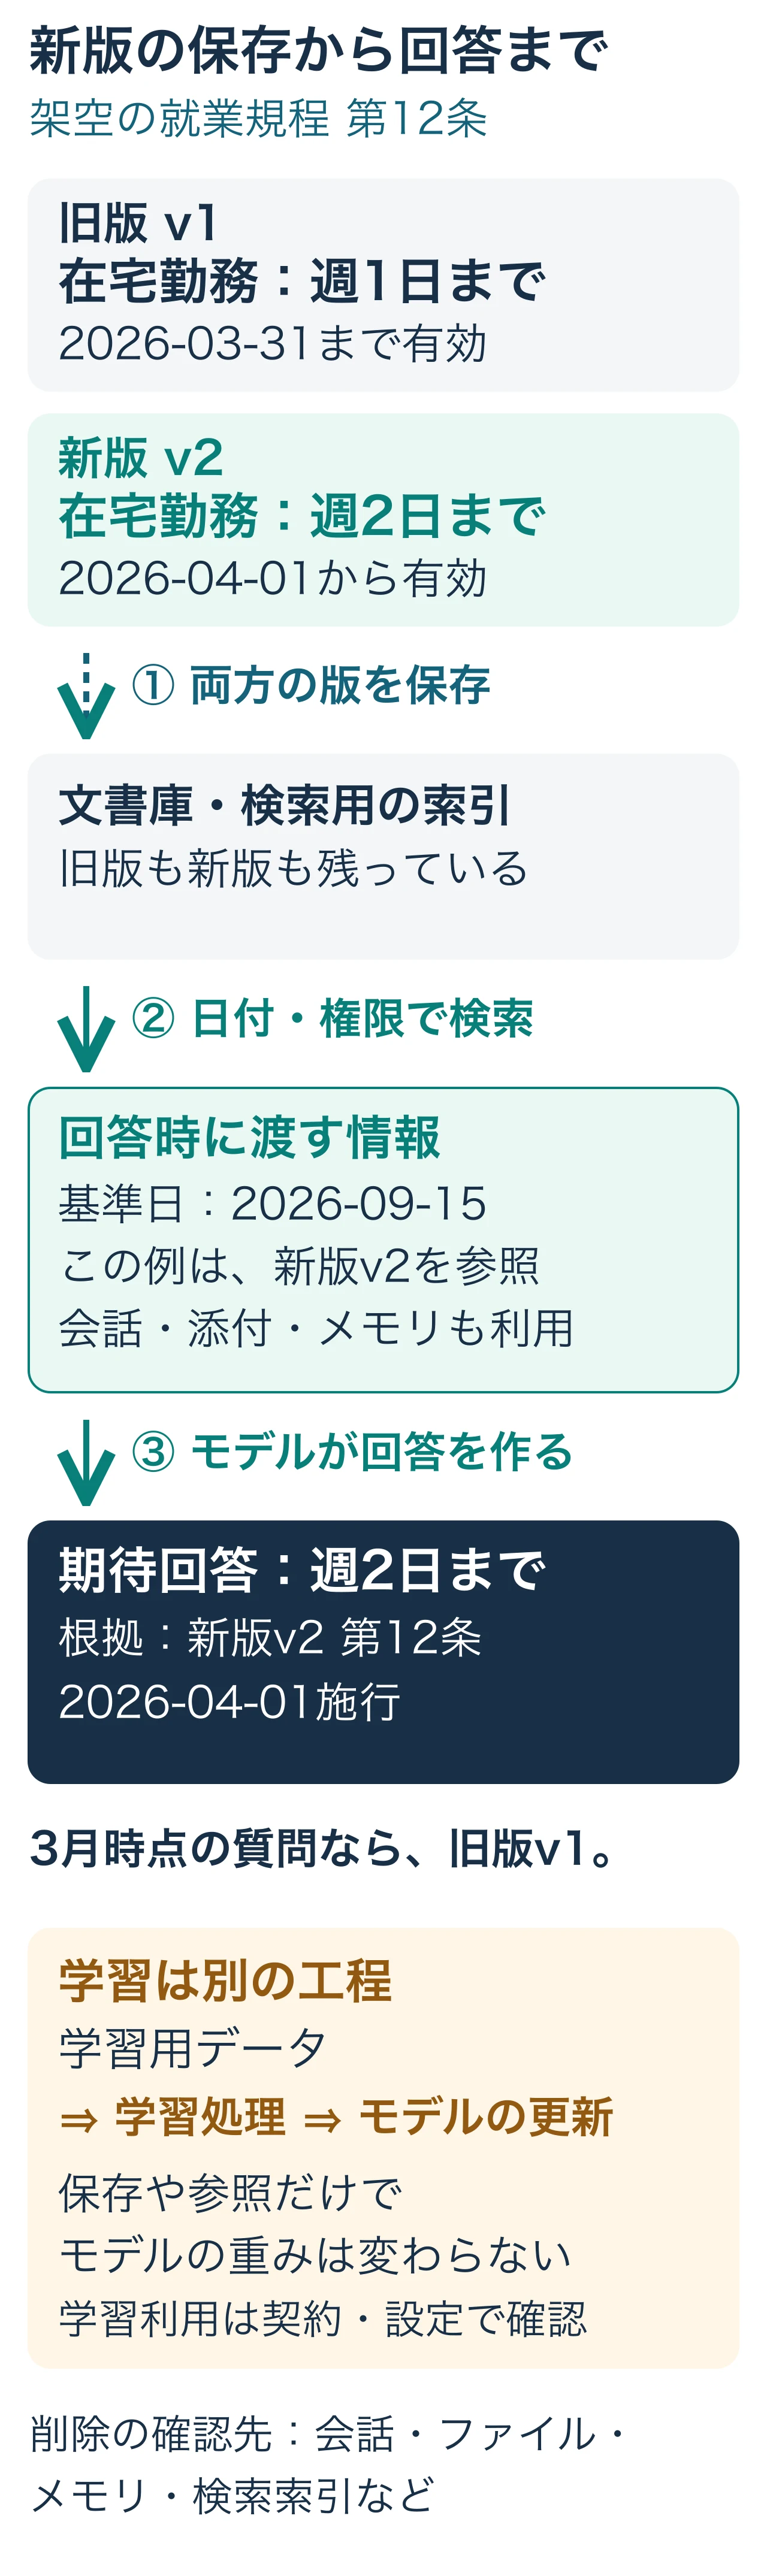
図1 保存、回答時の参照、学習による更新の違い(架空の説明例)。「週2日まで」は資料の設定から導いた期待回答で、AIの実行結果ではありません。会話・添付やメモリも回答に利用できますが、メモリを規程の正式な版の代わりにはしません。
保存、回答への参照、学習はどう違うか
ここでいう学習は、回答を生むモデル内部の数値である「重み」を更新する処理です。会話に資料を入れ、その内容に沿って答えが変わることとは区別します。「この資料を覚えて」と頼んだだけでは、どちらが行われたかは分かりません。学習による数値の更新は、OpenAIのモデル開発の説明で確認できます。
会話・メモリ・検索結果は、いずれも回答時に渡す情報として組み合わせられます。長文入力も、会話内参照で一度に多くの情報を渡す使い方です。
表1 保存・回答利用・モデル更新で見る、四つの方式
| 方式 | 保存される | 回答に使う | モデルを更新する |
|---|---|---|---|
| モデルの学習 | 学習結果を反映した重み(数値) | 重みが出力に働く。原文の検索とは別 | する。学習処理によって更新 |
| 会話内参照・長文入力 | 会話・添付など。保存条件は製品次第 | 今回渡された本文・会話・要約など | 参照するだけでは更新しない |
| 保存メモリ | 利用者の前提・好みなどの情報や要約 | 製品が文脈として利用する情報 | 参照するだけでは更新しない |
| 外部資料の検索 | 資料本体・検索用の索引など | 検索で取得し、今回渡した資料部分 | 検索するだけでは更新しない |
「保存される」は残る対象、「回答に使う」は今回参照する情報を示します。学習結果の重みと原資料の保管先は別です。製品ごとの保存期間や、入力内容の学習利用は、後述の設定・契約で確かめます。
更新するときも手段は違います。会話なら必要な資料を再提示し、メモリなら内容や設定を見直し、検索なら資料と検索用の索引の更新を確認します。モデルそのものを変えたい場合は、別の学習工程として考えます。比較表と記入票(Excel)には、方式ごとの詳細条件、記入済み見本、空欄票を収録しています。
画面に残っている会話が、毎回すべて渡るとは限らない
長い会話では、履歴の一部が省略されたり、要約に置き換わったりすることがあります。前の発言が画面に見えることと、その原文が今回の回答に渡されることを分けて考えます。
APIの情報量の上限と会話の圧縮
コンテキストとは、回答時にモデルが扱う情報の範囲です。OpenAIのAPIでは、その上限に入力と出力、モデルによっては考えるために使う情報も含まれます。資料に使える量は、この合計の上限によって変わります。公式説明では、文字数とは異なる単位で入力と出力を数えています。
長い会話への対応には、履歴の一部を省く、要約する、必要な箇所を検索し直すといった設計があります。OpenAI APIにも会話の状態を圧縮する機能があります。圧縮した情報は人が読む文章と異なる形式を取ることもあるため、画面に過去の発言が残っていても、全文が毎回そのまま渡されるとは断定できません。
容量に収まることと、正しく答えることも別です。必要な条文が渡っていない場合と、渡っているのに読み違えた場合では対処が違います。OpenAIの回答の正確さを改善する解説も、与える情報と、その情報を使った回答を分けて考えています。
会話を分ける際は、決定事項・対象資料・未解決事項を短く引き継ぎ、重要な条文は原文を再提示する運用から試せます。
参照した版を、回答からたどる
旧版の答えが返ってきたら、次の順に確かめます。AIの「覚えています」という返答に加え、ファイル名、版、出典の本文を開くのが出発点です。
- 別チャットか。前の資料を今回も参照できる機能・設定かを確認します。別チャットでもメモリなどが働く製品はあるので、「必ずゼロから」とも決めつけません。
- 参照対象に入っているか。添付の処理状況、検索対象、アクセス権、出典を確認します。表示だけで分からない処理は、製品の説明や管理者に確認します。
- 旧版を使っていないか。ファイル名だけでなく施行日と条文を開きます。新版の登録や旧版の除外を行った後は、検索結果への反映も確認します。
- 質問の条件が足りるか。「いつ時点」「誰に適用」「現行の確認か、新旧比較か」を補います。正しい資料が渡っていても、解釈の誤りは別に確認します。
たとえば「2026年3月時点の制度」が質問なら、旧版v1の週1日が期待回答です。新版への入れ替えは、現在の制度を聞く場合の対処です。また、OpenAIの検索用索引の仕様では、削除の反映に時間差があります。反映状況が不明なら、管理者が検索結果と登録状態を確認します。
ChatGPTのメモリ要約や回答の参照元表示も手がかりになります。ただし、表示に含まれない情報もあるため、表示だけで内部の参照処理のすべてを確認することはできません。
保存と学習利用の設定を確認する
具体的な設定例にはChatGPTとOpenAI APIを使います。2026年9月17日に設定・メモリの公式FAQを再確認しています。設定名は英語版表記です。製品・契約・言語・組織設定によって表示や提供状況が異なるため、自分の画面と管理者の案内を照合してください。
個人向けChatGPT
学習利用は、Web版のSettings > Data Controls > 「Improve the model for everyone」で確認します。オフにすると、その後の新しい会話はモデルの学習に使われませんが、履歴は残ります。自らフィードバックを送った会話は学習に使われる場合があります。Data Controls FAQとデータの学習利用方針に、この設定と例外が説明されています。
メモリは、公式FAQが案内するSettings > Personalization > Memoryが確認先の一例です。メモリをオフにする操作と、元の会話やファイルの削除は別です。情報を取り除くときは、メモリ要約と、その情報を含む会話・ファイル・接続アプリも確認します。
ChatGPT Business/EnterpriseとAPI
Business/EnterpriseとOpenAI APIの入出力は、既定ではモデルの学習に使われません。学習利用、保存、入力してよい情報は、それぞれ契約・管理者設定・接続先の扱いを確認してください。
APIでも学習利用と保存は別です。ログ・会話・ファイル・検索用索引の条件は、データ管理の公式文書と、保存先・外部送信を確認する手順で確かめます。自社アプリや接続先に残る情報も含めて判断してください。
最初に決めるのは、更新したい情報と、今回の回答に使わせたい資料です。一度の比較なら対象資料を明示し、継続的な問い合わせなら更新・版・権限を管理します。保存、参照、学習利用を分ければ、確認すべき設定や担当者も絞れます。
資料の置き場や名前を整える段階では、社内検索AIの資料整理|更新・廃止・閲覧権限で準備する内容を確認できます。資料の整理後に検索の仕組みを導入したい場合は、社内文書検索の開発・導入相談で依頼できる範囲を確認できます。
生成・検索・計算の役割から理解したい場合は、同じ注文を扱う三つの例が参考になります(生成AI・LLM・機械学習の違いを仕事の例で知る)。
参考出典
- OpenAI「Conversation state」:入力・出力を含む情報量の上限。API向け(確認:2026年9月15日)
- OpenAI「Data controls in the OpenAI platform」:学習利用と機能別の保存条件。API向け(確認:2026年9月15日)
- OpenAI「Memory FAQ」:ChatGPTのメモリ、要約、参照元表示、削除(確認:2026年9月15日)
- OpenAI「How ChatGPT and our foundation models are developed」:学習によるモデル内部の数値の更新(確認:2026年9月15日)
- OpenAI「Data Controls FAQ」:個人向けChatGPTの学習利用設定と履歴(確認:2026年9月15日)
- OpenAI「How your data is used to improve model performance」:個人・組織・APIの学習利用方針と例外(確認:2026年9月15日)
- OpenAI「File search」:登録済みファイルの検索と回答への利用。API向け(確認:2026年9月15日)
- OpenAI「Retrieval」:検索対象の絞り込みと削除反映の時間差。API向け(確認:2026年9月15日)
- OpenAI「Compaction」:会話状態の圧縮。API向け(確認:2026年9月15日)
- OpenAI「Optimizing LLM Accuracy」:与える情報と回答の正確さを分けて評価する考え方。APIの回答改善向け(確認:2026年9月15日)
あわせて読む
規程を変えたのに、社内検索AIは古い期限を答える。資料の更新・廃止・権限の整え方
更新した規程が検索に出ない、廃止した資料から回答される。経費精算の例で、資料の置き場、更新日、管理担当、見られる人を整理します。変更後の検索と回答を試し、古い情報が残った場所を調べられます。
丁寧な返信のために、契約書までAIに渡しますか?情報漏えいを防ぐ7つの社内ルール
問い合わせの返信案に、どの情報を入れてよいか。社員が使う7つのルールと、管理者が確かめる契約・保存・権限設定を対応付けます。条件が不明なときの相談先や、誤入力時の連絡もひな形へ書き込めます。