
AI開発のデータが足りているかは、件数より先に、何に使うデータが、どの評価条件で不足したのかで判断します。足りないのが件数なら追加収集、正解なら基準づくり、対象条件なら偏りの補正が候補になります。必要な情報が既にあるなら方式変更、準備が難しい範囲は対象縮小や見送りも比べます。
約12分で読めます
240件と12,000件、役に立つのはどちら?AI開発のデータ不足の見分け方
データを増やす前に、何の判断に、どんな情報が足りないかを確かめます。量・正解付け・偏りが異なる3例を比較。追加収集、方式の変更、対象の絞り込みを、費用と担当まで含めて選ぶ質問票付き。
影山 湧亮 / NeoLogic株式会社 代表取締役。元警視庁。現場業務の整理と生成AI活用・Webシステム開発を一貫して担当。
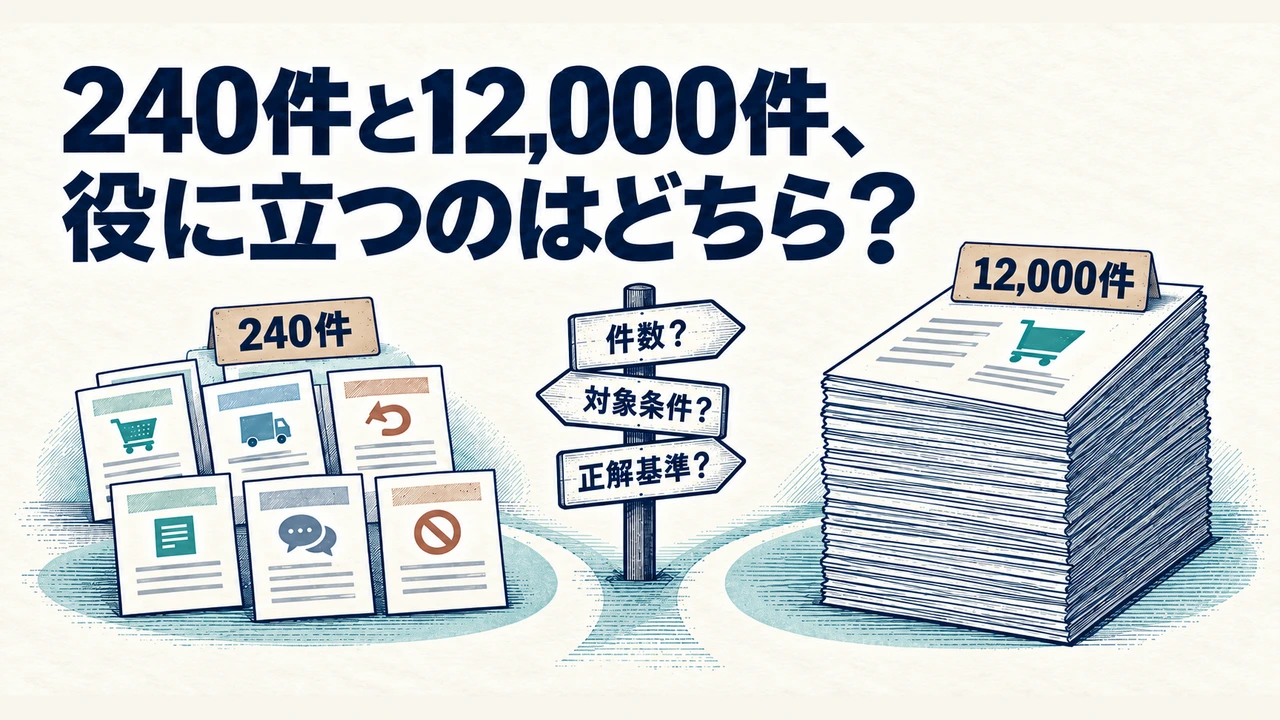
「AIの精度を上げるには、データをもっと集める必要があります」という提案書だけでは、何を何件増やせばよいのか、追加費用を認めるべきかは決まりません。
分類・抽出・社内回答などの限定用途で、データの出所と、正解を決める人を記録できる段階から使える判断手順です。必要件数や費用は案件の条件に合わせて決めます。件数・対象条件・正解基準がそれぞれ足りない三つの場面で考えます。
240件と12,000件で、確かめられることは違う
問い合わせを在庫・納期・返品・取消・複数用件・対象外の6条件へ分類する例です(想定例)。対象期間は2026年7〜8月、1件は独立した問い合わせ1通、利用条件と正解基準はA・Bで同じと仮定します。ここで比較するのはデータの構成で、学習後の精度は未測定です。
表1 6条件を含む240件と、1条件だけの12,000件
| 条件(互いに重複しない区分) | A:少量・6条件 | B:大量・1条件 |
|---|---|---|
| 在庫照会 | 40件 | 12,000件 |
| 納期照会 | 40件 | 0件 |
| 返品条件 | 40件 | 0件 |
| 取消依頼 | 40件 | 0件 |
| 複数用件 | 40件 | 0件 |
| 対象外 | 40件 | 0件 |
| 合計 | 240件 | 12,000件 |
6条件の抜けを調べるならAを先に使えます。ここでの「代表性」は対象条件を含むという意味で、現場の出現比率とは違います。全体品質は実運用の比率を別途把握し、条件別の結果と分けて集計します。逆に対象が在庫照会だけなら、Bの重複・鮮度・利用条件を点検して使う選択も成立します。
何に使うデータが足りないのか
学習用はモデルの振る舞いを調整する材料、検索用は回答時に参照する根拠、評価用は品質を確かめる問題と判定基準です。社内回答で資料が見つからないときに、分類の学習例を増やしても、同じ不足を補ったことにはなりません。まず見積りの「データ整備」がどれを指すか、表2で分けてください。
評価は目標、データ、指標を定め、結果を比較する手順で進めます。OpenAIの評価資料の原則を踏まえ、表2では準備項目と投資への結び付け方を発注者向けに整理しました(出典:OpenAI「Evaluation best practices」)。
表2 データ用途別の準備表
| 項目 | 学習用 | 検索用 | 評価用 |
|---|---|---|---|
| 用途 | 分類・抽出などの振る舞いを調整する | 回答時に根拠となる資料を取得する | 使ってよい品質か、変更が効いたかを確かめる |
| 利用許諾 | 学習・加工・委託の利用条件 | 複製・索引化・閲覧・外部送信の条件 | 評価・採点者への共有・保存の条件 |
| 正解の作り方 | 教師あり学習では入力と望ましい出力を対にする | 元になる文書と有効な版を管理者が決める | 分類ラベル・抽出値・回答の必須要素を業務責任者が確定する |
| 欠けた条件 | 対象条件の例、ラベルの一貫性 | 根拠本文、更新情報、閲覧範囲 | 独立した問題、例外、採点基準 |
| 追加収集で検証する仮説 | 不足条件の例を加えると、その条件の誤りが減るか | 必要な根拠を補うと、検索漏れが減るか | 未確認条件を加えても品質基準を満たすか |
| 記録する日付・版 | 案件ごとに記録 | 文書の更新日・版 | 評価集合・採点基準の版 |
| 根拠URL | Googleのデータ分割資料 | NISTの生成AIプロファイル(PDF) | OpenAIの評価資料 |
| 注意点 | 件数だけで学習の必要性は決まらない | 資料があっても取得・回答に失敗し得る | 少数の成功を本番全体の品質としない |
教師あり学習の「正解ラベル」は、問い合わせの分類先や請求書から取り出す日付のような、望ましい出力です。一方、検索対象の文書すべてに模範回答を付ける必要はありません。検索の良し悪しを測る質問と関連文書、回答の採点基準は別に用意します(出典:OpenAI「Evaluation best practices」、hotchpotch「JQaRA」)。
利用許諾の欄には、許可の有無だけでなく契約・ライセンス等の根拠と、加工・外部送信・再委託・保存の範囲を書きます。公開資料や自社保有資料という名前だけで判断せず、用途ごとの利用条件を調べる運用にします。不明点は契約・情報管理担当へ戻し、確認済みの範囲だけを予備調査に使います。
不足という説明の根拠を聞く
「試した範囲では高い正答率でした」という説明も、それだけでは追加投資の根拠になりません。同じ形式ばかりを試したのか、難しい条件も含むのかで意味が変わります。試した件数と正答数、対象期間、抽出方法、失敗の種類、正解の確認者をセットで出してもらいます。
誤りを次の四つへ分けると、件数追加が先か、別の準備が先かを選べます。「AIが間違えた」を全部、学習件数の不足にまとめないための診断です。
表3 不足の診断から、先に試す案を選ぶ
| 見つかった不足 | 先に試す案 | 確かめること |
|---|---|---|
| 必要な事例・根拠がない | 欠けた事例・資料を追加収集。用途と利用条件が合う公開資料も比較 | 分類例なら、12,000件に欠けた他の5条件を補えるか。検索なら、質問に答える根拠本文があるか |
| 根拠はあるが取得できない | 旧版・重複・読み取り不良を整理し、検索・入力・処理の方式を見直す | 同じ根拠を使って、取得できなかった条件の失敗が減るか |
| 取得したが読み違える | 資料の加工や指示を見直す。合成した言い換え・例外で原因を調べる | 調整用の例だけでなく、独立した実データでも誤りが減るか |
| 人の判定も割れる | 業務責任者が正解基準と判定保留の条件を決め、正解を付け直す | 問い合わせ800件の「急ぎ」について、同じ例の判定理由をそろえられるか |
準備が難しい条件は、対象を絞って人へ戻す案も残します。公開資料だけでは社内固有の用語・規程を補えず、合成データだけでは現実の出現比率や未知の失敗は分かりません。根拠や正解が存在しても、品質を判断する独立事例の件数が足りない場合は、後述の請求書18件の例のように評価材料を増やします。
評価担当者向け:調整用と最終確認用を混ぜない
学習・検証・テストは分け、集合をまたぐ重複に注意します。Googleのデータ分割資料を踏まえ、元の案件やスレッド、その言い換えを同じ側へまとめ、調整に使う例と最終確認に使う例を分ける運用を勧めます(出典:Google「Datasets: Dividing the original dataset」)。 最終確認の答えを見て調整したら、その集合だけで未見の仕事への品質を主張しません。
検索AIでは、本番でも参照する元になる文書が検索対象に入っていることと、評価専用の模範回答を混ぜることを区別します。本番で参照する元になる文書は検索対象に残し、実際には与えない答えを評価時だけ与えていないかを確認します。
また、少数の確認で問題が見つからなくても、本番全体で誤りが出ないとは言えません。狭い非体系的な評価から能力を広く推定せず、データの出所・出力の出典を確かめます。NISTの生成AIプロファイル(PDF)を踏まえ、予備調査では分かった条件と未確認の条件を残します(出典:NIST AI 600-1(PDF))。
増やす以外の案も比較する
表3で選んだ案を、追加収集と正解基準の二つの場面で具体化します。既存資料を整理してから不足分だけ集める、対象を絞りつつ人の判定を残す、といった併用もできます。
評価件数が少ないなら、まず確かめる材料を増やす
請求書から支払期日を取り出す仕事で、利用条件と正解基準は決まっているとします。同じ形式の独立した評価候補が18件しかない場合です(想定例)。この段階では、学習の必要性を決める前に、品質を判断する材料の少なさを確かめます。同じ対象条件の独立事例を追加し、合意した誤りの上限を満たすかを確かめます。18件を合否の境界にはせず、必要件数は、評価担当者に根拠とともに提案してもらいます(出典:Google「Datasets: Dividing the original dataset」)。
依頼するときは、「支払期日を読み違えると何が困るか」「1件ずつ人が見直す運用か」「どの形式・例外を含めたいか」を先に伝えます。そのうえで、例えば「追加200件という提案は、何をどの程度の確かさで判断するためですか。形式別の内訳と、誤りが出たときに追加する条件も示してください」と聞きます。件数・費用だけの提案なら、判定基準が分かるまで依頼範囲を確定しません。
人の正解が割れるなら、収集より先に基準を決める
問い合わせ記録800件で、「急ぎ」の判定が2名の担当者で割れる場合です(想定例)。先に業務責任者が急ぎの条件と判定保留の扱いを決め、同じ少数例を別々に判定して、不一致の理由を確認します。根拠が入力にないなら、入力項目や人へ戻す手順を変える案が先です。単に多数決でラベルを付けたり、記録を追加したりしても、何を正解とするかは決まりません。
正解付けの実例として、JQaRAは質問と候補文に関連ラベルを付け、モデルの出力と人の判定で見直す構築方法を公開しています。この考え方を「誰が正解を確かめるか」を決めるときに使えます。社内規程の更新・閲覧権限・回答保留のテストには、自社の資料で別に問題を作ります。
合成データを使う場合も、作った言い換えが現実の不足を埋めたかは別に確かめます。合成データへの過度な依存による均質化等のリスクを踏まえ、生成元と派生関係を残します(出典:NIST AI 600-1(PDF))。正解を業務側が確定したうえで、実際の対象業務から独立して確保した評価データでも確かめる運用を勧めます。
準備の費用と担当を決める
追加費用を読むときは「データ作成一式」を、取得、利用条件の調査、加工、正解付け、見直し、更新へ分けます。見積りには、発注側の見直し時間、基準変更による再作業、評価の実行費、納品後の更新も含むかを書いてもらいます。件数だけでなく、有効件数の数え方、単価、確認回数、初期費と継続費をそろえるためです。
表4は、在庫照会だけに偏ったデータを補う案を検討する記入済み見本です。金額や必要件数が決まっていない項目は、都合のよい数字を埋めず未確定としています。空欄版と回答担当・確認状態の欄は、データ準備・追加収集の確認票(Excel)をお使いください。
打ち合わせでは、まず三つを聞きます。「何に使い、何を1件と数えるか」「どの条件の、どんな誤りを減らすか」「追加後に誰が何で確かめるか」です。在庫照会だけの12,000件なら、単に件数を増やす見積りではなく、欠けた5条件をどう補うかが答えになるはずです。
表4 追加収集の見積りを読む質問票
| 質問 | 記入済み見本(先ほどの問い合わせ分類) |
|---|---|
| 何に使い、何を1件と数えますか。 | 上の問い合わせ分類。1件は独立した問い合わせ1通。同一スレッドや複製を別件に数えない。 |
| 不足の根拠と、今回変える条件は何ですか。 | 6条件が対象だが既存12,000件は在庫照会のみ。欠けた5条件を補う。品質改善は未測定。 |
| 利用許諾・契約等の根拠と送信範囲は分かっていますか。 | 社内指定環境で加工・評価可能と仮定。外部送信は対象外。学習への利用・外部委託等の条件は別に調べる。 |
| 誰が、どの基準で正解を付けますか。 | 現場担当が6条件の区分を付け、業務責任者が不一致を確定。「複数用件」と「対象外」を別区分にする。 |
| 調整用と最終確認用をどう分けますか。 | 元の案件単位で分離し、同一スレッド・言い換えの派生元を分割先へまたがせない。最終確認用は調整に使わない。 |
| 取得から更新まで、誰の費用を含みますか。 | 取得・利用条件の調査・加工・正解付け・見直し・更新を分ける。発注側の見直し時間、再作業、評価実行費も記録する。 |
| 数量・単価・回数・初期費と継続費は明記されていますか。 | 有効件数、作業時間、見直しの回数、更新頻度を記載。金額・単価・期間は未見積り。取得件数と検収件数を区別する。 |
| 改善しない場合は、何をして、いつ止めますか。 | 条件別誤り・重大誤り・見直し時間を比較。改善が乏しければ入力・指示・処理方式を見直し、在庫照会に対象を絞る案も比較する。 |
| 今回の仮説を否定する結果は何ですか。 | 欠けた条件を補っても当該条件の誤りが減らない、または別条件の悪化や見直し負担の増加がある。 |
| 記入日・根拠と、残る不明点はどこに残しますか。 | 記入日2026-09-15。出所・案件ID・採点基準・評価結果を同じ記録へ。費用・効果・必要件数は次の見積りで決める。 |
例えば、利用根拠が分からない外部データの収集は、この予備調査の進め方だけでは着手を決められません。データ提供者の利用条件、委託契約、社内の情報管理規程を取得し、契約・法務等の担当者が判断します。正解を決める人が不在の場合も、件数追加の発注より担当の確定を先にします。
開発全体の前提をそろえる方法は、システム開発の相見積り|条件をそろえる比較表で説明しています。
予備調査から投資を判断する
予備調査では、追加する条件、減らしたい誤り、増えては困る重大な誤り、人の確認負担、作業の上限と停止条件を決め、次に何へ投資するかを絞ります。効果や費用の具体値は実測・見積りが得られてから記入します。
改善前後は、同じ対象範囲、独立した評価条件、同じ採点基準で比べます。方式・モデル・指示文まで一緒に変える場合は、データ追加だけの効果とは言わず、変更の組み合わせとして記録します。調整後には、使い回していない最終確認用の例でも確かめます(出典:OpenAI「Evaluation best practices」、Google「Datasets: Dividing the original dataset」)。
欠けた条件で改善が見え、残るリスクと更新費用を引き受けられるなら追加投資へ進みます。資料があるのに取得できないなら方式を見直し、準備できない範囲が残るなら対象縮小を選びます。利用条件や業務上の正解が固まらず、確認の費用も見合わないなら、見送りが妥当です。
追加収集の前に、「この条件のデータを補うと、この失敗が減るはずだ」という検証可能な仮説と、その成否を確かめる材料を用意します。見積りにこの一文と見直す担当が書けるかを、次の打ち合わせの出発点にしてください。
データの準備が見えたら
検索用の資料そのものを整える段階なら、社内検索AIの資料整理|更新・廃止・閲覧権限へ進んでください。予備調査の後に本番化や見送りの条件を決めるなら、試作・PoC・MVPから本番へ進む条件と見送る条件が関連します。
データがそろった後は、要約・分類・回答など用途ごとの失敗を試す評価表へ落とせます(AI機能の品質評価|要約・分類・回答・実行のテスト)。
用途・使えるデータ・品質条件が整理でき、既存業務への組み込みを検討する段階では、利用ルールの整備から専用機能の開発まで相談できます。
参考出典
- OpenAI「Evaluation best practices」:用途別の目標・評価データ・指標、人による評価の照合
- NIST AI 600-1(2024年7月):出所と根拠の確認、評価の一般化の限界、偏りと合成データへの過度な依存(PDF)
- hotchpotch「JQaRA」:日本語の質問・候補文・関連ラベルの作成と確認方法
- Google「Datasets: Dividing the original dataset」(2025年12月3日更新):学習・検証・テストの分離と重複への注意
情報確認日:2026年9月15日。
あわせて読む
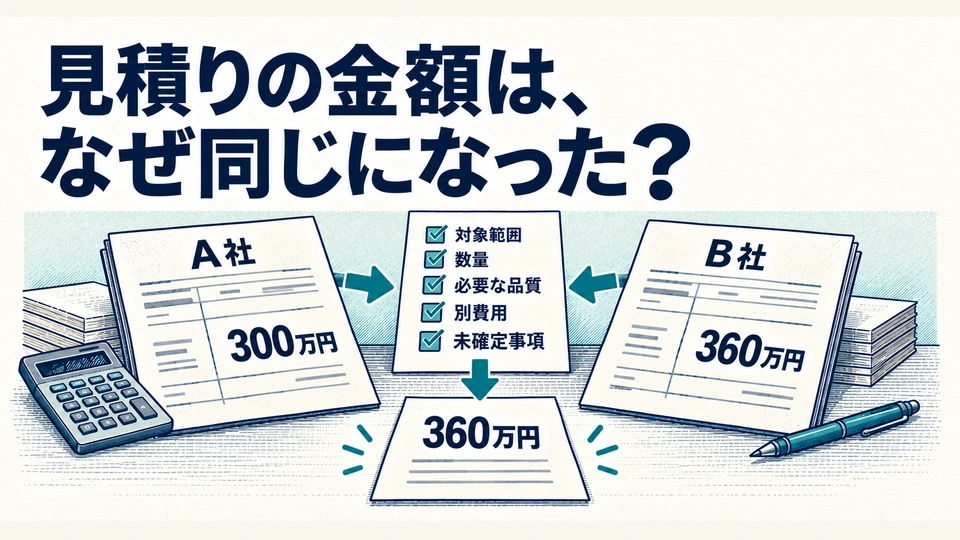
300万円と360万円の見積り、条件をそろえたら同じ額に。相見積りの比べ方
安い見積りにも、移行や操作説明が入っているでしょうか。当初の記載から質問、回答後の比較までを追います。初期費用と12か月の総額、担当不在時の引き継ぎをそろえて比べる記入例です。
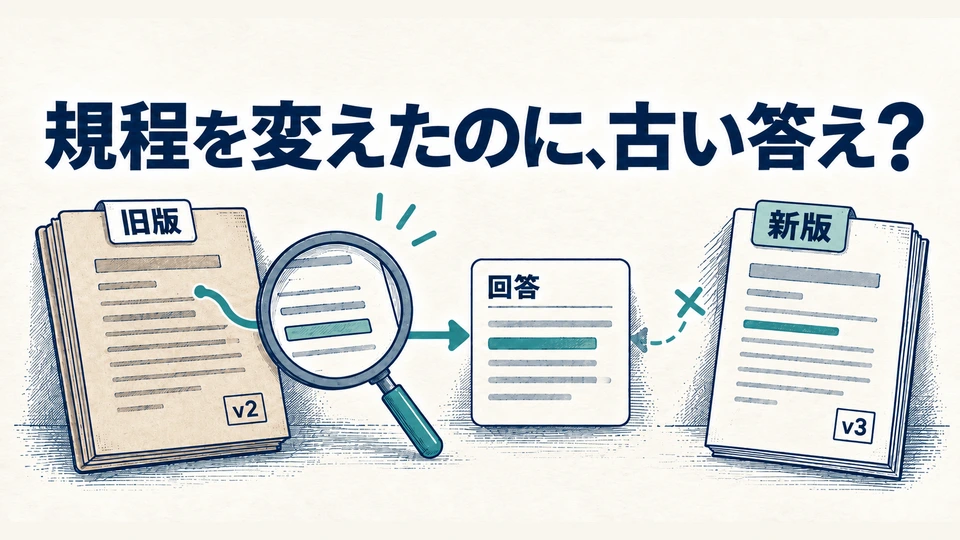
規程を変えたのに、社内検索AIは古い期限を答える。資料の更新・廃止・権限の整え方
更新した規程が検索に出ない、廃止した資料から回答される。経費精算の例で、資料の置き場、更新日、管理担当、見られる人を整理します。変更後の検索と回答を試し、古い情報が残った場所を調べられます。