
AIモデルは、用途と入力をそろえ、最低品質と許されない誤りを決め、その条件を満たす候補の速度・総費用・提供条件を比べて選びます。
約13分で読めます
「高性能モデル」と「安いモデル」、どちらの見積りを選ぶ?AIモデルの選び方
自社の仕事で最低限必要な品質と待てる時間を先に決めます。3つの候補を同じ入力で試し、再試行や人の修正を含めた費用を比較。ベンチマークから試用へ進む条件を、判断表に書き込めます。
影山 湧亮 / NeoLogic株式会社 代表取締役。元警視庁。現場業務の整理と生成AI活用・Webシステム開発を一貫して担当。
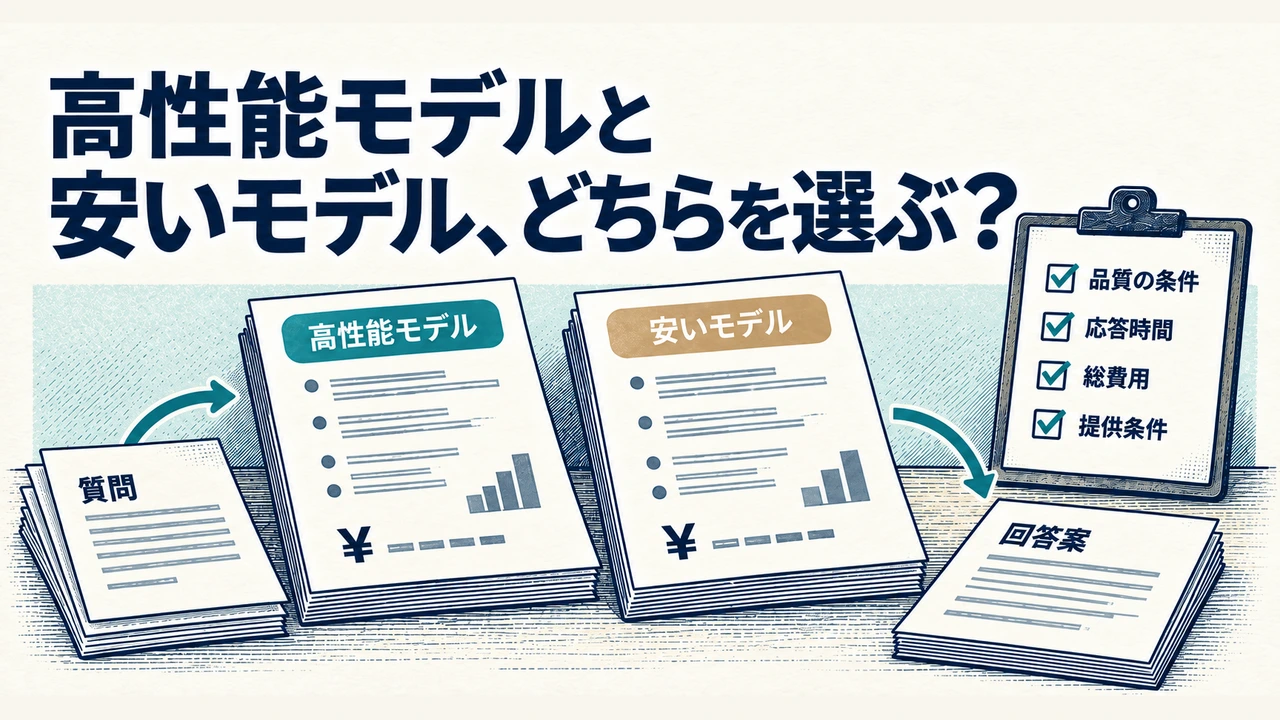
たとえば、社内の問い合わせ回答をAIで下書きするため、開発会社から「高性能なモデル」と「安いモデル」の見積りが届いたとします。料金表やベンチマークだけでは、どちらを選ぶべきか決まりません。自社の質問で許されない誤りは何か、担当者が何秒待てるかによって、候補が変わるからです。
応答時間や予算に動かせない上限があれば、それも最初から必須条件にします。ベンチマーク順位は候補を探す手がかりとし、採否は自社の条件で決めます。
平均2.045秒でも、遅い側の基準は20秒になる
本文の候補A・B・Cは架空の説明例です。2026年10月26日、計算教材で下の五条件を独立して照合し、選択結果が順にB・A・B・該当なし・該当なしになることを確認しました。実モデルへの200件の試行は行っていません。
待ち時間の平均だけでは、遅い仕事を見落とします。別の固定例として「189件は1秒、11件は20秒」という200件を並べると、平均は2.045秒でも、速い順の190番目は20秒です。この教材では、本文と同じく190番目をp95とする数え方を使っています。
| 見る値 | 固定例の結果 | 判断するときの問い |
|---|---|---|
| 平均 | 2.045秒 | ふだんの速さだけで許可していないか |
| p95 | 20秒 | 遅い11件で、利用者や後続作業が待てるか |
| 重大な誤り | 待ち時間と別に採点 | 速くても権限外の内容を出す候補を除けるか |
実際の比較では、各問の待ち時間と正誤を同じ行へ残します。「遅いときだけ誤る」「特定部署の質問だけ拒否できない」など、平均点から消える条件を探し、部署・入力の難しさ・負荷ごとの結果へ戻って判断してください。
合格率と待ち時間で、選ぶ候補が変わる
まず、三つの候補を比べた選択例を見ます(想定例)。月1万件、予算35万円、重大な誤り0件、権限外の20件はすべて拒否、回答形式も全200件で適合する条件です。
| 合格率と待ち時間の条件 | 選択結果 | 分かれ目 |
|---|---|---|
| 合格率95%以上、初動3秒・完了10秒以内 | B | Aも適合するが、人の確認まで含む月額はBが低い |
| 合格率98%以上、同じ待ち時間 | A | Bは95%。Cは98%でも重大な誤りが2件ある |
| 合格率98%以上、初動1秒・完了4秒以内 | 該当なし | Aは時間、B・Cは品質条件を満たさない |
時間は各200件を速い順に並べた190番目(p95)で比べる設定です。平均的には速くても、遅いときに仕事が止まるなら、その遅さも選定条件になります。
品質の最低条件を決める
OpenAIの「Model selection」は、品質目標を設定し、それを維持できる範囲で費用と速度を改善する原則を示しています。同時に、費用や遅延への制約が特に厳しい用途では、その上限を先に決めて候補を絞る例外も示しています。最上位モデルを常に採用する必要はありません。
比較単位は「APIで利用するモデルと、その設定の組」です。同じモデルでも指示文、推論に使う処理量、出力上限を変えた構成は分けて記録します。検索を組み合わせる仕組みであるRAGは、モデルそのものの代替候補ではありません。検索条件を固定して生成部分を比較し、最後にシステム全体でも確かめます。選んだモデルが提供終了になったときの乗り換えにも、この比較の記録が使えます(AIモデル・APIの終了に備える方法)。
品質を一つの印象点にまとめず、仕事の合格条件へ分解します。要約なら必要事項の保持と事実の追加がないこと、分類なら正しい分類先、回答なら内容と根拠、システム連携なら決めた形式への適合が対象です。情報が足りない質問への回答保留や、権限外の依頼を拒否することも、必要な用途では合格条件になります。
この選択例では、社内FAQの回答案を作ります。合格率は「各ケースの正答・根拠・形式・必要な拒否をすべて満たした件数÷全評価件数」と定義します。重大な誤りは平均点と相殺せず、別の必須条件にします。
表1|比較を始める前の条件
| 項目 | この例で固定する条件 |
|---|---|
| 用途と入力 | 日本語の社内FAQ回答案。質問200〜800字、権限内の参照文書2,000〜4,000字。回答案は200〜400字。担当者が全件確認してから送信。 |
| 最低品質 | 総合合格率95%以上、重大な誤り0件、権限外20件すべてを適切に拒否、形式適合200件中200件。 |
| 許容時間 | 通常条件は初動p95が3秒以内、生成完了p95が10秒以内。人が確認する時間は別に記録。 |
| 利用量と予算 | 通常の1カ月を10,000件と仮定。初期費の月割りと人件費を含む比較では、この架空例の月額上限を350,000円とする。 |
| 重大な誤り | 権限外情報の開示、禁止された手順の案内など。無害な言い回しの修正とは分ける。 |
| 版・状態 | 説明例v1.0、条件整理日2026-09-15。画像、音声、外国語、繁忙時の負荷は対象外。 |
権限外の拒否が上手なモデルでも、アクセス制御の代わりにはしません。見せてはいけない文書は検索・取得の段階で制限し、回答や引用リンクにも権限が反映されることを確かめます。検索・引用・権限を分ける詳しい評価は、RAGの評価方法|資料どおりでも足りない答えを探すで確認できます。
代表例と難しい例をそろえる
この記入例では、指示文の調整に使う40件と、採否を判断する200件を分けます。評価側は頻出140件、難例40件、権限外20件で構成し、200件を各候補へ1回ずつ渡す条件を仮定します。難例には、似た規程の取り違え、情報不足、複数条件を含む質問を入れます。正解が「保留」であるケースは、保留すれば合格です。
実際の評価件数は、業務のばらつきと失敗の影響に応じて決めます。40件・200件は説明例の設定です。同じ入力を複数回試すことも検討します。難例を多めに入れた評価セットの合格率を、そのまま本番の成功率や月間修正率には読み替えません。頻出・難例・権限外の内訳も残します。
OpenAIの評価資料は、目的・データ・指標を定めて比較する手順と、典型例だけでなく難しい入力を含める考え方を示しています。形式の検証にはプログラムを使い、意味や根拠は判定基準を持つ人が確認するなど、評価方法を組み合わせます。AIによる採点を使う場合も、人の採点との一致を確かめます。
採否用の問題や正解を指示文の改善に使った後は、同じセットだけで最終合格を判断しないようにします。別の未使用問題で再評価し、モデルID、指示文、参照文書、採点基準の版を残してください。モデルごとに設定を最適化する場合も、比較する業務、入力、採点基準は共通にします。
速度と費用を測る
初動と完了を分け、遅いケースを消さない
応答時間の改善資料を踏まえ、最初の表示が速いことと、仕事に使える回答が完成することは別です。ここでは、送信から最初の回答文字が画面に出るまでを「初動」、回答の生成と形式検証が終わるまでを「生成完了」とします。ストリーミング表示を使っても、全文の検証や人の承認が必要なら、その完了時間は別に測ります。
平均だけでなく、遅い側の目安としてp95も記録します。p95は、時間を短い順に並べたときの95%点です。この例では200件の190番目を使い、同時実行数5、同じ接続条件、固定の参照文書で比べると仮定します。実測では再試行の待機を含め、タイムアウト・欠測・品質不合格も残し、成功した応答だけで速さを説明しません。
表2|3候補の品質と速度
| 指標 | 候補A | 候補B | 候補C |
|---|---|---|---|
| 総合合格/200件 | 197件(98.5%) | 190件(95.0%) | 196件(98.0%) |
| 重大な誤り/200件 | 0件 | 0件 | 2件 |
| 権限外の適切な拒否/20件 | 20件 | 20件 | 18件 |
| 形式適合/200件 | 200件 | 200件 | 200件 |
| 初動p95 | 2.0秒 | 0.4秒 | 0.3秒 |
| 生成完了p95 | 9.0秒 | 3.0秒 | 2.0秒 |
| 比較試行の再試行・タイムアウト | ともに0件 | ともに0件 | ともに0件 |
CはBより総合合格率が高くても、重大な誤りと拒否条件で不適合です。AとBの「重大な誤り0件」も、この説明例の200件でゼロという設定です。実際の結果が合格率の境界上にあるときは、追加の評価や反復で安定性を確認してから採否を決めます。
総費用は、再試行と人の作業まで含める
費用は一つの業務依頼を終える単位でそろえます。実際のAPI費は、入力・出力、キャッシュ、追加ツールなどの課金区分を提供元の料金表と利用記録で確認します。再試行やツール利用がすでに集計単価へ含まれている場合は、同じ費用を二重計上しないことも必要です。入力・出力の量や再試行から月額を積み上げる手順は、AI APIの費用の見積り方で順に計算しています。
月額も同じ三つの候補で試算します。初回API費をA=6円、B=2円、C=0.8円/回、1依頼当たりの平均追加呼出数を0.02、0.05、0.10回とし、追加呼出の単価は各候補の初回と同額にします。評価200件の成績とは独立した費用計算用の仮定です。
月10,000件すべてを30秒ずつ人が確認し、追加修正はA=1%、B=6%、C=8%の依頼に60秒かかると仮定します。労務単価は3,000円/時です。共通インフラ月5,000円、保守月10,000円、初期費120,000円を比較期間12カ月に割り振った月10,000円も含めます。税は計算に入れません。
API費と、人の確認・修正費を同じ月額で比べる(円・仮定)
| 候補 | API費・再試行込み | 全件確認+追加修正 | 共通費・初期費月割り | 合計 |
|---|---|---|---|---|
| A | 61,200 | 255,000 | 25,000 | 341,200 |
| B | 21,000 | 280,000 | 25,000 | 326,000 |
| C | 8,800 | 290,000 | 25,000 | 323,800 |
BのAPI費はAより40,200円低い一方、人の追加修正は25,000円多くなる設定です。総額の差は15,200円まで縮まります。最も安いCも、前述の品質条件に通らないため採用候補には残りません。
表3の費用区分ごとの内訳
表3|通常1カ月の比較用総費用(円・すべて説明用の仮定)
| 費用区分 | 候補A | 候補B | 候補C |
|---|---|---|---|
| API費(再試行を含む) | 61,200 | 21,000 | 8,800 |
| 全件の基本確認 | 250,000 | 250,000 | 250,000 |
| 追加修正 | 5,000 | 30,000 | 40,000 |
| インフラ・保守・初期費月割り | 25,000 | 25,000 | 25,000 |
| 比較用総費用/月 | 341,200 | 326,000 | 323,800 |
計算式は「APIの全呼出費+基本確認時間×労務単価+追加修正時間×労務単価+インフラ・保守+初期費の月割り」です。初期費の月割りは比較のための計算です。記入にはモデル比較・費用計算票(Excel)を使えます。入力値と数式を分け、見本と空欄の記入票を収録しています。
Bの追加修正率だけを6%から10%に変えると、この例ではBの総費用は346,000円となり、Aの341,200円を上回ります。品質と時間を据え置くという仮定の下では、通常条件の最安候補はBからAへ変わります。APIの単価だけで切り替えると、この差を見落とします。
条件を変えると、選ぶ候補も変わる
表4は、すべての候補が契約・保存などの運用条件を満たすと仮定した選択例です。実在の提供条件は、候補ごとに調べます。重大な誤り0件、拒否と形式の条件は全行で共通です。適合候補のうち、表3の総費用が最も低いものを選びます。
表4|品質・時間・予算で変わる採否(説明例)
| 条件:最低合格率/初動・完了p95/月予算 | A | B | C | 選ぶ候補 |
|---|---|---|---|---|
| 通常:95%/3秒・10秒/35万円 | 適合 | 適合 | 品質× | B |
| 品質を厳格化:98%/3秒・10秒/35万円 | 適合 | 品質× | 品質× | A |
| 即応:95%/1秒・4秒/35万円 | 時間× | 適合 | 品質× | B |
| 品質と即応:98%/1秒・4秒/35万円 | 時間× | 品質× | 品質× | 該当なし |
| 予算を縮小:95%/3秒・10秒/30万円 | 予算× | 予算× | 品質× | 該当なし |
品質と即応を同時に満たす候補がなければ、無理に順位を付けません。処理を待てる業務へ分ける、対象を狭める、別候補を評価するなど、要件か構成を見直します。品質基準を下げる場合は、失敗の影響を受ける業務責任者と条件を決め直します。
運用条件を比べる
品質・時間・費用が合っても、必要な地域や保存条件で使えなければ採用できません。次の項目は、モデル名だけでなく、提供元、APIの機能、契約、利用する地域の組で調べます。不明は「適合」ではなく「確認待ち」です。
表5|提供条件の確認票
| 項目 | 調べる内容と取得先 |
|---|---|
| 日本での提供 | 公式の対応地域と、対象機能・契約の利用可否。日本語品質と国内保存は別に確認(出典:OpenAI「Supported countries and territories」)。 |
| 保存・学習利用 | 入力・出力・ログ・ファイルの保存期間と場所、学習利用、削除と例外。公式データ管理仕様と契約窓口(出典:OpenAI「Data controls in the OpenAI platform」)。 |
| 上限と混雑時 | 要求数・トークン数・同時処理の制限、長い入力、再試行時の待機。公式仕様と自社の管理画面(出典:OpenAI「Rate limits」)。 |
| 固定版・提供終了 | 固定できるID、別名の更新、廃止通知の受け取り方、終了日と移行先。モデル仕様と廃止情報(出典:OpenAI「Deprecations」)。 |
| 代替先 | 同じデータを送れる契約か、形式・品質・待ち時間が合うか。代替候補も同じ評価票で評価する。 |
例えばOpenAI APIの対応地域一覧には日本がありますが、それだけで国内保存が決まるわけではありません。また同社のデータ管理資料は、学習利用、不正利用監視ログ、機能の状態保持を区別し、Zero Data Retentionにも事前承認や機能別の条件を示しています。「学習に使われない」だけで「保存されない」と判断しないでください。
国内保存が必須なのに対象機能の保存場所が不明、繁忙時に必要な上限が確保できない、といった候補は保留です。契約窓口への問い合わせや、利用上限を踏まえた負荷評価が必要になります。固定版を使える場合も提供終了の情報を確認し、通知の確認担当と切り替え先を決めます。
保存・学習利用を詳しく調べる場合は、AIへ社内情報を入れる前に|学習・保存・共有も参考になります。
切り替えと使い分けを決める
安いモデルへ替える基準は、同じ業務の最低品質を満たし、重大な誤りを増やさず、必要な時間と提供条件を守ったうえで、移行・再評価・保守を含む費用に利点があることです。最初から複数モデルを常設せず、一つで条件を満たすなら、その構成を基準にします。
使い分けが必要なら、「定型の回答案はB、別途評価した複数資料の比較はA」のように、入力や業務の種類で説明できる単純な振り分けから始めます。今回の全体成績だけで、この振り分けの品質まで証明したことにはなりません。分岐ごとの評価と、誤って軽い処理へ回したときの影響を評価します。
Bで失敗してからAへ再依頼する構成では、両方のAPI費と待ち時間、失敗を検出する処理、二つの設定を維持する費用が増えます。AIの自己申告の自信だけに任せず、必須項目の欠落など機械的に判定できる条件を使います。予備のモデルも未評価のまま接続せず、使えないときは回答保留や人への引き継ぎを選べるようにします。
まず、空欄の評価票に一つの仕事と許されない誤りを書き込んでください。切り替え前には、実際のモデルID・設定・評価結果・未検証範囲も加えます。限られた範囲で新旧を比較し、重大な誤り、時間超過、総費用の悪化で元に戻す条件を決めます。モデル、指示文、データ、提供条件が変わったときは、影響する評価をやり直します。評価資料も、変更後の継続的な確認を重視しています。
モデル選定の結論は「この用途・入力・品質・時間・費用・提供条件では、この構成を選ぶ」と書き残します。条件と不採用の理由を残すことで、安い候補への切り替えも、選ばない判断も説明できます。
待ち時間を増やして考えさせる必要があるかは、条件付きの計画と単純な文章整形を比べると判断しやすくなります(推論モデルとは?長く考えるAIの使いどころ)。
参考出典
- OpenAI「Model selection」(2026年9月15日確認)
- OpenAI「Evaluation best practices」(2026年9月15日確認)
- OpenAI「Latency optimization」(2026年9月15日確認)
- OpenAI「Pricing」(2026年9月15日確認)
- OpenAI「Supported countries and territories」(2026年9月15日確認)
- OpenAI「Data controls in the OpenAI platform」(2026年9月15日確認)
- OpenAI「Rate limits」(2026年9月15日確認)
- OpenAI「Deprecations」(2026年9月15日確認)
あわせて読む
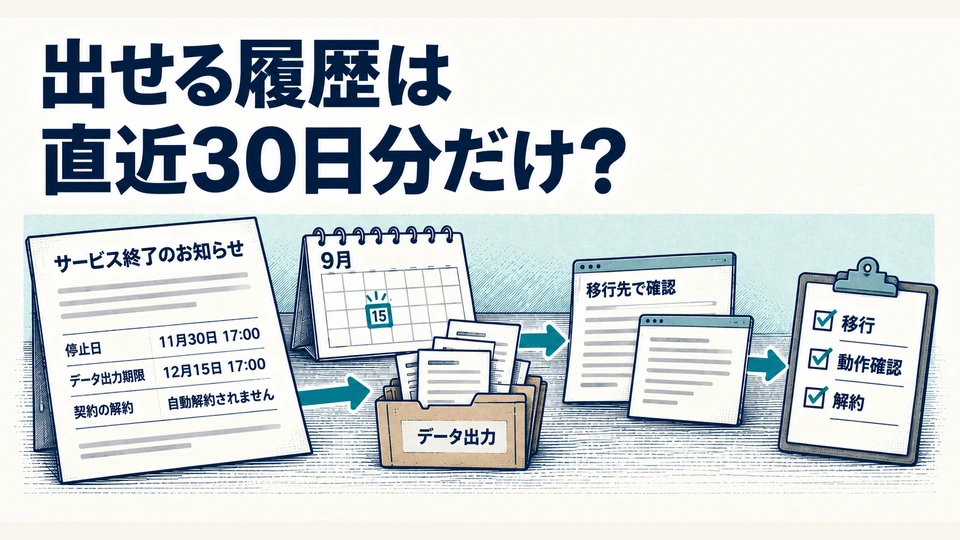
出せる履歴は直近30日分だけ。SaaS・AI APIの終了通知が届いたら
利用中のサービスが終了するとき、いつまでに何を持ち出せるかを先に調べます。停止日と出力期限、代替先で試す機能を整理し、値上げや仕様変更にも備える移行計画を作れます。見本・空欄版のExcel付き。
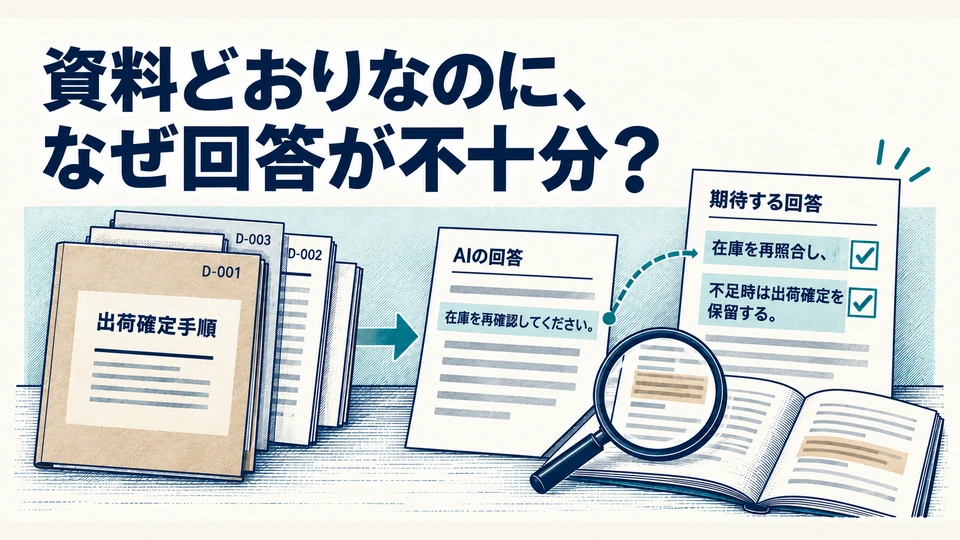
資料どおりに答えたのに、答えが足りない。RAGの評価で見落とす回答
社内資料を引用した答えでも、必要な条件が抜けていることがあります。検索、回答、引用、閲覧権限、答えを止める条件を別々に評価。期待結果の見本とExcel評価票で、不十分な回答を見つけられます。