
AIのベンチマークやIQ、「人間の何時間分」という数字が示すのは、決まった課題・比較相手・道具・試行条件のもとで、AIがどれくらいの確率で課題を達成したかです。会社の仕事をそのまま任せられるかは、別に確かめる必要があります。
約10分で読めます
「人間の8時間分」は、AIが8時間働いたという意味ではない。性能ニュースの読み方
AIの高得点や「人間の何時間分」は、何を測った数字なのでしょうか。課題、使った道具、試行回数をそろえて比較し、自社で試せる範囲を見極めます。IQの比較条件やMETRの時間の指標も読み分けられます。
影山 湧亮 / NeoLogic株式会社 代表取締役。元警視庁。現場業務の整理と生成AI活用・Webシステム開発を一貫して担当。
「AIのIQは160」「人間の8時間分の仕事を完了」という見出しを、採用や開発体制を変える判断に使えるか、元の評価条件から読み直してみます(想定例)。
読むときは、何を、誰と比べ、どの条件で、どれくらい確実に達成したかを見ます。高得点は、試す候補を見つける材料になります。
METRの時間地平は、人間の専門家が課題を終える時間と、AIの成功確率を対応させた指標です。たとえば「50%時間地平が8時間」なら、専門家が8時間かける課題に対して、AIの成功確率が50%になるという推定を表します。AIが連続して8時間働いた、と読むと意味が変わります(出典:METRの定義・FAQ)。
90%と80%を、そのまま比べてよいか
次の二つの成績を比べてみます(想定例)。
| 候補 | 発表された数字 | 実際に数えたもの |
|---|---|---|
| A | 成功90% | 最大5回の試行で、一度でも成功した課題の割合 |
| B | 成功80% | 1回の実行で成功した課題の割合 |
1回で答えを使う仕事なら、Aが優位かはまだ分かりません。再試行を認める場合も、費用・時間に加え、どの答えが正しいかを選ぶ方法が必要です。
ニュースから最初に拾うのは、課題と比較相手、成功の数え方、使えた道具と試行回数の三つです。数字が大きく見える理由を、元の報告まで戻って確かめます。
数字が測っている課題を読む
ベンチマークとは、一定の課題と採点方法で性能を測る試験です。選択問題を解く試験と、プログラムを修正してテストを通す試験では、同じ正答率でも達成した内容が違います。試験名に加えて、課題の実例と「何を成功としたか」を見ます。
次に確かめるのが、結果を当てはめられる対象の範囲です。ソフトウェア課題で測った結果を、営業交渉や経営判断も含む知的業務全般へ広げるには、その範囲を測る根拠が必要です。METRの原著も、領域や採点可能性を限定した課題を扱っています(出典:Kwaほか、課題群の説明)。
人間との比較にも条件があります。分野の専門家か一般参加者か、初めて見る仕事か、いつもの職場の仕事か。同じ「人間より高い」でも、比較した集団が違えば意味は変わります。人間側の人数や経験が書かれていなければ、「人間一般を上回った」と補って読みません。
問題の公開時期、評価用データの分離方法、学習データとの重なりも調べます。公開問題への高得点だけでは、未見の問題への対応力を切り分けられません。ただし、問題が公開されているという理由だけで、AIが学習済みだと断定することも避けます。人間向け検査をLLMに適用する研究でも、学習用の資料に検査材料が混じる可能性が論点になっています(出典:Löhnほか)。
IQという言い方に注意する
「IQ160」とあれば、検査名、対象年齢や基準となる集団、実施・採点方法を調べます。人間の心理検査では、得点をどの対象・用途で解釈できるかを明示し、新しい解釈には根拠を示すことが求められます(出典:AERA・APA・NCMEの検査基準、1.1〜1.4・5.8〜5.9(PDF))。
AIに解かせる際、図形を文章に変えたり、一部の問題だけを使ったり、再試行で最良の答えを選んだりすれば、人間が受けた検査と条件が変わります。人間の得点表に当てはめるだけでなく、その比較で同じ能力を測れているかを確かめる必要があります。人間向け検査をLLMに適用する方法と妥当性は、研究でも検討されています(出典:Löhnほか)。
冒頭のIQの見出しに「経営判断も人間超え」と続いていたとします。次のように条件を残して書き換えます。
あるIQ形式の問題で、特定の入力・採点方法による高得点が報告されたという主張です。検査名、基準集団、人間とAIを比較できる根拠は不明で、経営判断の能力はこの情報から確認できません。
高得点は、試した問題への対応力を示す証拠として評価できます。測っていない知能の側面や実務能力まで、その数字に足し合わせないことが読み方の分かれ目です。
作業時間の指標を正しく読む
50%と80%は、成功確率の水準が違う
METRは、課題ごとの人間の所要時間とAIの成否から、時間に応じた成功確率を推定します。50%時間地平はその確率が50%になる課題時間、80%時間地平は80%になる課題時間です(出典:METRの定義・FAQ)。
同じAI・同じ条件で、長い課題ほど成功しにくい推定曲線なら、より高い確実性を求める80%時間地平のほうが短くなります。50%の時間を0.8倍して80%の時間を出すことはできず、曲線の形が必要です(出典:Kwaほか、3.1・3.2.1)。
同じ程度の人間の所要時間でも、AIが得意な課題と苦手な課題があります。50%という表示を、どの個別課題でも半分の確率で成功すると読むと、この違いを落としてしまいます。また、成功確率と、推定値の不確実さを表す信頼区間は別です。80%成功と、推定の確かさが80%という意味を区別します(出典:METRのFAQ、Kwaほか、3.2)。
METRの課題数・試行・推定条件を詳しく読む
表は指標の定義と確認条件をまとめています。各モデルの順位を比べる際は、モデル別の採点対象と設定も確認します。根拠はMETRの現行ページ、TH1.1公開説明、原著です。
| 確認項目 | 定義・確認した事実 | 条件外・注意点 |
|---|---|---|
| 課題と母集団 | 主にソフトウェア開発・機械学習・サイバーセキュリティの、成功条件が明確な課題です。 | 課題を限定しており、会社の仕事全体を代表する標本にはしていません。 |
| 課題数・版 | TH1.1の2026年1月公表時は228課題です。 | 各モデルで実際に採点された課題数は、個別の結果・データで確認します。 |
| 人間側の比較対象 | 専門家が課題を終える時間を基準にします。多くは成功した試行の幾何平均です。 | 見積り等に依る課題もあります。自社で仕事に習熟した社員との比較には、別の時間測定が必要です。 |
| 成功条件 | 課題別の基準で成否を判定します。連続的な点数も基準値で成功・失敗に分けます。 | 成功条件を自社の受入条件と照合する必要があります。 |
| 50%時間地平 | 当該課題分布への当てはめで、成功確率が50%となる人間側の課題時間です。 | AIの連続稼働時間でも、すべての個別課題の成功率でもありません。 |
| 80%時間地平 | 同じ考え方で、成功確率が80%となる人間側の課題時間です。 | 50%値から一定の倍率では換算できません。100%の保証でもありません。 |
| 利用したツール | モデルに道具と実行手順を組み合わせて評価します。 | 端末・検索等の有無、道具の版、時間と入出力の量の上限を個別に確認します。 |
| 試行と分布 | 現行FAQは各課題6回の独立試行を説明しています。課題別の結果から曲線を推定します。 | 原著の旧実験は約8回です。版を混ぜず、採点対象・除外・重み付けも確認します。 |
| 推定の不確実性 | 現行ページは16時間を超える測定を、現在の課題群では信頼性が低いと注記しています。 | 16時間が能力の上限という意味ではありません。点推定だけで長時間能力を断定しません。 |
| 一般化できる範囲 | 同種の課題・条件で能力を比較する手がかりです。 | 他領域、組織の生産性、全業務の代替、IQへの換算は本指標では未確認です。 |
| 確認日・根拠 | 2026-09-15確認。現行ページの更新表示は2026-05-08です。 | 定義表であり、実在モデルの最新順位・性能値の一覧ではありません。 |
「人間の8時間分」を、元の条件から読み直す
次の図は、「専門家なら8時間のソフトウェア課題」「50%成功と推定」「端末・コード実行あり、人の介入なし」と仮定したものです(想定例)。80%時間地平、試行数、推定幅は不明として残します。
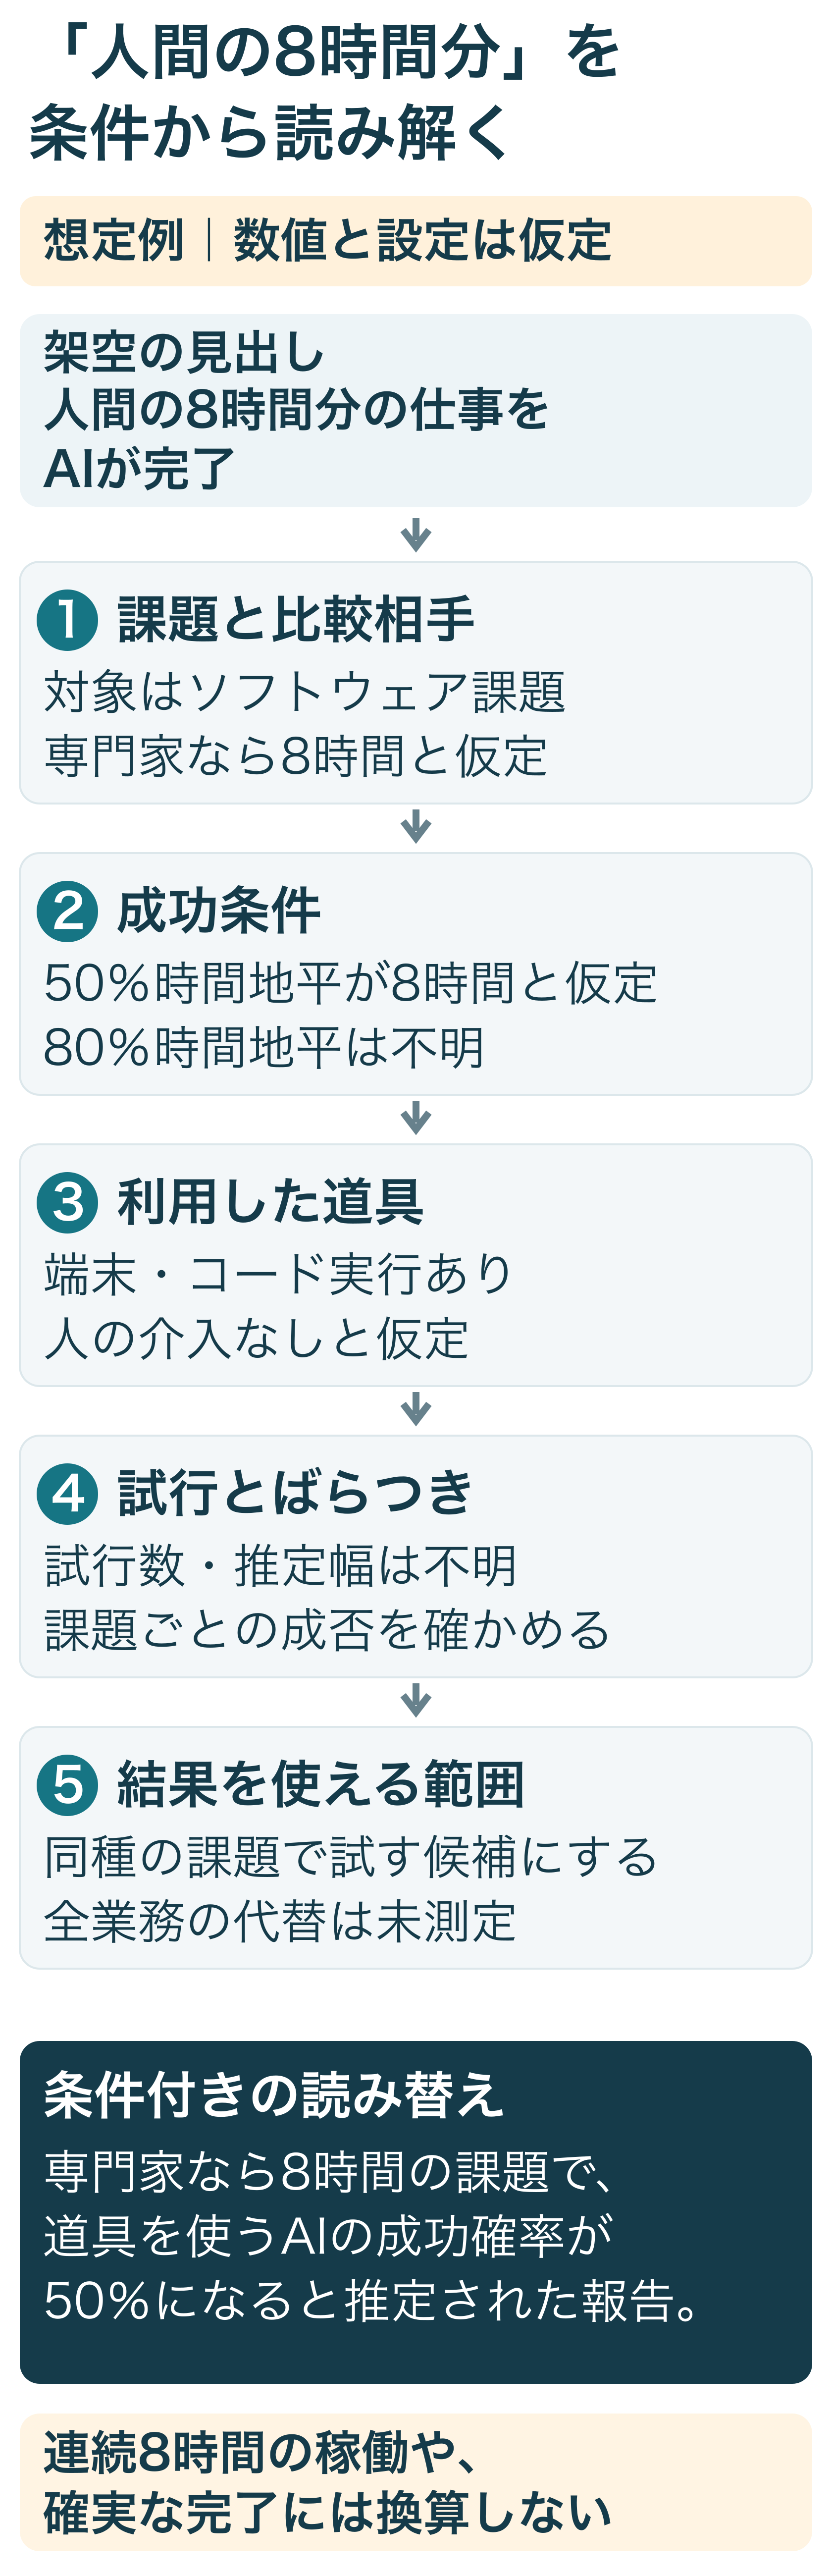
図1 「人間の8時間分」という見出しを、5つの条件から読み解く流れ(想定例)。8時間・50%・道具の設定は仮定です。
図の結論は、「専門家なら8時間かかるソフトウェア課題で、端末等を使うAIの成功確率が50%になると推定された、という報告」です。同種の課題で試す候補にはできます。80%以上の成功を要する業務や、端末を使えない環境に合うかは、追加の情報や試験で確かめます(出典:METR「Time horizons」、OpenAI「Evaluation best practices」)。
長時間の推定を読むときの、実測と見積りの内訳
定義表の「16時間超」の注意を、長い課題の内訳から見ます(出典:METR、Methodological Details・Updates)。
TH1.1の2026年1月の公開説明では、8時間以上の31課題のうち、人間の時間を実測したのは5課題で、残りは見積りです。この数字は当時の課題群の内訳として読み、現在の各モデルの採点件数と区別します(出典:METR「Time Horizon 1.1」)。
グラフを採用判断に使うときは、長い課題がどれほど含まれるか、実測と見積りの内訳、推定区間を見ます。観測点と、データに合わせた曲線、将来に延ばした予測線も区別してください。点推定だけで「丸一日の仕事を確実に任せられる」と結論づける前に、根拠の厚みを確かめます。
成績が変わる条件を確認する
同じモデル名でも、検索、端末、コード実行などの道具と、それを使う手順が違えば比較条件が変わります。METRもモデルに道具と実行ループを組み合わせて評価しています。「モデル単体」か「道具を含むシステム」かを確認します(出典:METR、評価手順のFAQ)。
最高点、全試行の平均、複数回で一度以上成功する割合は、違う問いへの答えです。制限時間、AIの入力・出力や推論に使える量の上限、実行費用、失敗した試行の除外も含めて見ます。TH1.1の公開説明でも、課題群や評価基盤を変えると推定値が変わることが示されています(出典:METR「Time Horizon 1.1」)。
採点者も確認します。機械的な正誤判定、人による評価、別のAIによる採点では、見ている品質が違います。AI採点を使う場合は、人の判断と合っているかを確かめます(出典:OpenAIの評価ガイド)。
条件は原報告の方法・付録・評価設定・公開データに戻って探します。記載がなければ「不明」と残し、同条件での優劣判断を保留します。問題が非公開なら学習資料との重なりがゼロ、試行数が多ければ必ず信頼できる、といった推測で空欄を埋めません。
会社で使えるかは別に確かめる
例えば、部品商社で見積り依頼への返信案に使うなら、商品名・数量・納期が資料と一致すること、不足情報を確認できることを試します。商品台帳の参照だけを許し、送信前に人が確認する想定です。ソフトウェア課題の高得点から、この返信品質までは分かりません。
品番違い、矛盾、情報不足を含む依頼で、使える案になるまでの修正時間と費用を記録します。自社で同じ仕事を試す手順はChatGPT・Claude・Geminiの比較へ進めます。試す範囲の原則は用途別の評価ガイドが参考になります。
性能ニュースの確認票(Excel)には、METRの定義表、記入済み見本、空欄票を収録しています。確認できなかった条件は「不明」、実験していない点は「未測定」として残します。
性能ニュースを読んだ後のメモは、「この課題・この相手・この道具・この試行条件では、ここまで確認できた」という一文から始められます。残った空欄を次の調査や試験に回せば、高い数字への期待を、条件のある利用判断へ変えられます。
AIの仕組みや、モデルとエージェントの違いを続けて知りたい場合は、次のガイドへ進んでください。
自社の人員や仕事の配分を考えるときは、性能の得点に加え、実際の作業時間を測った研究の読み方も役立ちます(AIで仕事はどう変わる?時間短縮と雇用の読み方)。
参考出典
- METR「Task-Completion Time Horizons of Frontier AI Models」TH1.1、2026年5月8日更新:Methodological Details・FAQ・Updates
- METR「Time Horizon 1.1」2026年1月29日:228課題、8時間以上31課題と人間時間実測5課題の内訳
- Kwaほか「Measuring AI Ability to Complete Long Software Tasks」arXiv:2503.14499v4:2.1〜2.3・3.1・3.2.1・4
- OpenAI「Evaluation best practices」:用途別評価、評価工程、人の判断と自動採点の照合(改訂日表示なし)
- AERA・APA・NCME「Standards for Educational and Psychological Testing」2014年英語版:1.1〜1.4(冊子23〜24ページ)・5.8〜5.9(104ページ)(PDF)
- Löhnほか「Is Machine Psychology here?」INLG 2024、230〜242ページ:著者抄録の検査妥当性・学習資料との重なりの論点
一次資料の確認日:2026年9月15日。
あわせて読む
ChatGPT・Claude・Gemini、3つとも契約する?仕事で選ぶ2段階の比べ方
使いたい仕事、入力する資料、出典、契約条件から候補を絞ります。同じ三課題で根拠や修正時間を比べ、既存契約で足りるかを判断。公式にある機能と、自社で試して分かる品質を記入できる比較表付き。
下書きは速くなったのに、仕事全体では?AIで仕事はどう変わるかの読み方
下書きの時間が短くなっても、確認・修正や教育の仕事は残ります。問い合わせ業務の計算例とILO・METRなどの研究を使い、作業時間、品質、雇用の指標を読み分けます。人の配置を考える前に役立つ判断材料です。