
AIの評価や判断は、そのまま採用せず、判断の影響、誤判定の種類、書式ごとの差、理由を確かめる方法、訂正できる入口をそろえてから利用範囲を決めます。同じ形式の点数でも、入力や評価基準に偏りがあれば判断は偏るためです。人が見直す場合も、原資料を読み直して判定を変えられる条件が必要です。
約10分で読めます
正解率が高くても、特定の書式で間違えたら?AIの評価を採用する前に
全体の正解率が高くても、一部の人や条件に誤りが集中することがあります。企画案の比較例を使い、理由の確かめ方と人が見直す範囲を検討。異議や訂正を受け付ける方法も判断表に書き込めます。
影山 湧亮 / NeoLogic株式会社 代表取締役。元警視庁。現場業務の整理と生成AI活用・Webシステム開発を一貫して担当。
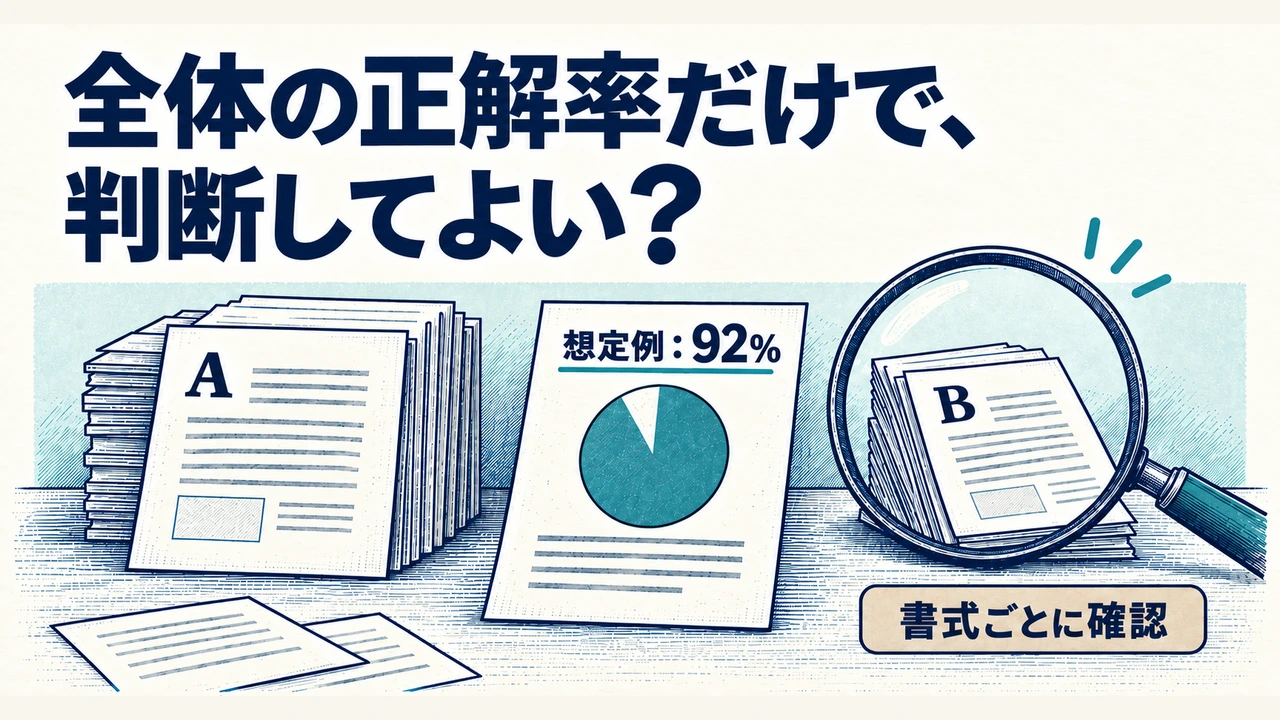
たとえば社内の企画案をAIで採点し、全体の正解率が92%だったとします(想定例)。担当者も目を通すので、そのまま審査対象を絞ってよいでしょうか。見るべきなのは、点数の高さだけでなく、誰の案がどんな理由で審査から遠ざかるかです。
AIの比較・評価結果を意思決定に使う経営者や担当者向けの検討方法です。採用・人事評価など、生活や機会への影響が大きい判断にも関わる論点を扱います。個別の選考・融資システムの設計や適法性は、実際の条件で別に検討してください。後半には、実際のAIを試す前に用意する比較課題も載せています。
全体では100件中92件が正解。でも、少数の書式Bでは10件中6件が誤り。
この例では、全体の92%だけを見て採用すると、この差を見落とします。書式が原因かどうかは、まだ分かりません。
訂正の窓口がない、締切前に見直せない、結果を撤回できない場合は、審査からの除外に使わず、評価項目の整理までにとどめます。
正確さと公平さは別の問い
ここでいう正確さは、人が原文と基準から先に決めた正解(参照判定)とAIの判定が一致することです。公平さは、それだけでなく、評価に無関係な条件で不当に不利にならないかを問います。参照判定に使う基準そのものが不適切なら、AIが忠実に再現しても問題は残ります。「同じ点数が出る」「人の判定と合う」「公平である」は別々に確かめます。
まず、企画案を「審査へ進める」と「補足待ち」に分ける場面を考えます。補足待ちの案を放置すれば、書類整理のつもりでも、提案の機会を事実上失わせます。その判定の後に何が起きるかを、利用目的とともに書き出してください。
100件を、項目別の書式Aが90件、連続文章の書式Bが10件という構成にします。各群の半数が参照判定で「審査へ進める」、残り半数が「補足待ち」です。同じ基準による二分類を想定した数値で、実在する提案者の属性や能力とは関係しません。
表1 全体正解率と少数群の誤り
| 対象 | 件数 | 正解数 | 全体正解率 | 群内の誤り |
|---|---|---|---|---|
| 全体 | 100件 | 92件 | 92.0% | 8/100件(8.0%) |
| 書式A | 90件 | 88件 | — | 2/90件(2.2%) |
| 書式B(少数群) | 10件 | 4件 | — | 6/10件(60.0%) |
全体正解率は92÷100で92%ですが、少数群のBでは10件中6件が誤りです。「—」は全体だけに置く指標のため非該当を表します。AとBの比率を単純平均せず、全体は件数を合計して計算します。小さなB群の割合だけで一般化したり、この差を直ちに書式の因果効果と決めたりもしません。後段の練習では、別の4企画を使って内容をそろえた比較を設計します。100件の原因を調べた結果ではありません。
NISTは、生成AIの有害な偏りに群・言語間の性能差を含めています(AI 600-1、2.6、本文8ページ(PDF))。内閣府指針も公平性、人間中心、透明性を考慮要素としています(1(2)、本文3ページ(PDF))。こうした原則を利用判断へつなぐには、全体平均と書式ごとの結果を分けて読みます。
偏りが入る場所
偏りを探すときは、元データ、選ぶ属性、評価指示、判定基準、利用者の受け取り方の五つを点検します。それぞれ別の場所に偏りが入り得るため、五つとも見ます。
元データでは、どの書式や事例が評価用データに多いかを見ます。過去に採用された案ばかりを正解の見本にすれば、見落とされた案を検討できません。正解ラベルの付け方や、判断が分かれた案件の扱いも見ます。
選ぶ属性では、内容の評価に必要な情報と、関係のない情報を分けます。属性欄を消しても、別の情報が属性の手掛かりとなる場合があります。NISTも、言語の特徴や画像の付随情報などが集団属性の手掛かりになり得る点を点検対象にしています(MS-2.11-004、本文36ページ(PDF))。「属性を入力しないから公平」という判断には、この点の確認が欠けています。
評価指示では、「優秀そう」「説得力がある」などの曖昧な表現を、根拠を指せる項目に置き換えます。判定基準では、何点なら審査に進めるかだけでなく、欠けた情報をどう扱うかを決めます。資料の不足を、企画の質や提案者の能力の不足と読み替えないことが、この例のルールです。
利用者の受け取り方では、AIの順位や点数を見て人が追認していないかを見ます。NISTは自動化への過度の依存をHuman-AI Configurationのリスクとして扱っています(2.7、本文9ページ(PDF))。人を工程に置くことに加え、その人が独立して見直せるかも確かめます。
また、誤りは方向を分けます。この例の「誤って補足待ち」は、条件を満たす案の機会を遅らせる誤りです。「誤って審査へ」は、情報が足りない案を進める誤りです。表2は表1と同じ100件の内訳で、各列の分母は異なる参照判定の件数です。
表2 誤判定の方向別の件数(表1と同じ100件)
| 対象 | 誤って補足待ち | 誤って審査へ |
|---|---|---|
| 書式A | 1/45件(2.2%) | 1/45件(2.2%) |
| 書式B | 3/5件(60.0%) | 3/5件(60.0%) |
| 全体 | 4/50件(8.0%) | 4/50件(8.0%) |
ここでは二つの誤りが同数ですが、同じ重さと決める必要はありません。期限までに訂正できるか、失われる機会を戻せるかによって、優先して防ぐ誤りを決めます。群別の数字は、その判断の材料です。公平性の合否を自動で決める基準にはしません。
AIの理由を検証する
「対象者が不明確なので2点です」という説明を受け取ったら、原資料のどの記述と評価項目が対応しているかを確かめます。生成AIは理由や引用にも誤った内容を含み得ます(NIST AI 600-1、2.2、本文6ページ(PDF))。MS-2.5-003は、出力の出典・引用の確認を挙げています(本文31ページ(PDF))。
FAQ検索を改善する企画には、「社内ヘルプデスク担当を対象に、FAQを探しやすくする」と明記しています。AIが対象不明と評価したら、人はその一文と評価表を見比べ、「対象の記載あり」と訂正します。一方、制約が書かれていない問い合わせ分類の企画は、その不足箇所の補足を求めます。理由の文章が自然に読めても、最終通知へ転記する前に原資料と照合します。
異議があったら、理由を原文に戻す
提案者:「対象が不明という判定ですが、FAQ検索の企画に「社内ヘルプデスク担当」と書いています。見直しをお願いします」
別の担当者:「原文と評価基準を読み比べ、対象の記載がありました。「対象不明」は訂正します。ほかの必須項目も原文で見て、締切前に審査へ進めるかをお知らせします」
これは後段の4企画を使った応答の見本です。対象が書かれていると分かった段階で、企画全体の合格まで決めたとは扱いません。見直しが締切に間に合わなければ、除外を保留します。
見直し記録には、原資料の版・該当箇所、適用した評価項目、AIの点数と理由、人の判定、変更理由を残します。引用が正しくても、その箇所が本当に結論を支えるかは別に読みます。出力された説明とモデル内部の計算過程も区別します。資料との整合性は確認できますが、説明文だけで内部の判断原因まで証明することはできません。
利用範囲と人の確認を決める
この企画審査なら、AIは評価項目の整理と根拠箇所の候補出しまでにとどめ、審査に進めるかは人が原資料から決める運用を提案します。AIの低順位案件を人の一覧から消せば、候補整理でも実質的な除外になります。表示順を変える場合も、未確認の案が埋もれないよう全件を追える必要があります。
人の確認者には、原資料へアクセスする権限、読み直す時間、AIと異なる判断をする権限、処理を止める方法を持たせます。例えば、先に人が基準との対応を記録し、その後でAIの点数を比較する方法が考えられます。採用選考の記録そのものをExcelや採用管理システムでどう持つかは、採用応募の管理の選び方で扱っています。
表3 企画審査でAIを使う範囲の記入例
| 判断項目 | 記入済み見本 |
|---|---|
| 判断の影響 | 補足待ちが続くと、提案者が審査の機会を失う。AI単独で除外しない。 |
| 誤判定の種類 | 条件を満たす案の見落としを優先して確認。不足案を進める誤りも別集計。 |
| 群別の差 | 全体正解率92%。Aは2/90件、Bは6/10件の誤り。原因は未確認。 |
| 異議と訂正 | 提案者は審査事務局へ再確認を依頼できる。別の確認者が原資料を再読し、審査締切前に訂正・通知する。間に合わなければ除外を保留。 |
| 人が見直す情報 | 原資料・評価基準・AIの理由と引用・未記載情報・変更前後の判定・変更理由。 |
| 記入日 | 2026-09-15。モデル・設定・実行日は、試したときに記入する。 |
| 根拠 | 原則は内閣府指針とNIST AI 600-1(参考出典)。点数と集計値は記入例。 |
| 次に調べること | 採用・融資等の実運用、実在する属性間の公平性、訂正に必要な時間。 |
判断票には、再確認を受ける担当と訂正・通知の期限まで記入します。実際の採用をAIの要約と点数だけで決め、原資料を確認できないケースは、この企画審査の例では対応できません。
足りない情報は、AIの提供元から評価対象・群別の試験条件・版・制約を、業務責任者から評価基準と訂正手順を聞き取ります。人事や法務などの担当者には、実際の判断に適用される法令・社内規程の確認を依頼します。
内閣府指針は、人間中心、公平性、透明性などを考慮し、主体や用途に応じた取組を促しています(1(1)〜1(3)、2(1)〜2(2)、本文2〜6ページ(PDF))。NISTは米国の任意枠組みです。どちらも、この判断票を満たせば公平・適法と認定する資料ではありません。表3の再確認窓口は運用例であり、一般に一律の法定の異議申立権があることを示すものでもありません。
自社で試す別の練習:同じ企画を二つの書式で比べる
次に、同じ内容で書式だけを変える小さな検証を設計します。表1の100件とは別に、企画を4件用意しました(想定例)。ここでは「対象」「確かめ方」「制約」の記載を各1点で確認し、3点なら審査へ、2点以下なら補足待ちとする説明用ルールです。点数は記載の充足度だけを表し、企画の価値や人物の能力の順位には使いません。
表4 AIを試す前に決めておく参照判定
| 企画 | 参照点数 | 参照判定と理由 |
|---|---|---|
| Q01 FAQ検索改善 | 3/3点 | 審査へ。対象・確かめ方・制約が記載されている。 |
| Q02 議事録の様式統一 | 3/3点 | 審査へ。対象・確かめ方・制約が記載されている。 |
| Q03 問い合わせ分類 | 2/3点 | 補足待ち。制約の記載がない。 |
| Q04 在庫一覧の整備 | 2/3点 | 補足待ち。確かめ方の記載がない。 |
各企画の文言を保ったまま、項目別の書式Aと連続文章の書式Bを作ります。一度に変えるのは提示形式だけとし、基準、モデルの版、指示文、出力形式、利用できる設定をそろえます。各入力を新しいセッションで3回ずつ評価する設計なら、4件×2書式×3回で24出力です。順番は入れ替えて記録し、参照判定はAIの結果を見る前に固定します。
24出力を人が照合し、書式を変えた組の点数・判定・根拠箇所の差と、同じ入力を繰り返した際の揺れを分けて記録します。差が出たら、まず入力の情報が本当に同じかを確認し、複数の条件を同時に変えずに原因を調べます。差がない場合も、四つの架空事例だけで公平性を保証しません。NISTも、狭い評価から性能を一般化しないよう求めています(MS-2.5-001、本文31ページ(PDF))。実在の集団・文脈に応じた評価は、別に設計します(MS-2.11-002、本文36ページ(PDF))。
判断表には、企画本文の書式A・B、検証設計、記入済み見本、空欄版、24出力分の記録欄を用意しています。数式は書式別の件数・割合を再計算するためのものです。実在する属性や言語による差、実務での訂正のしやすさは、別の課題で確かめます。実データによる確認を追加する際は、利用目的や取り扱う権限、保管範囲を先に確認してください。
まず一つの業務について、何の整理にAIを使い、何を原資料から人が判断し、異議が出たらどこへ戻すかを記入してみてください。判断票の未確認欄を埋め、利用範囲と次の確認先を決めます。
AIエージェントの操作範囲や承認・停止の役割を整理したい場合は、AIエージェントの監督|問い合わせ返信で考えるで説明しています。
参考出典
あわせて読む
面接は決まったのに、案内を送ったか分からない。採用管理はExcel・ATS・連携のどれ?
2職種へ応募した人の面接予定、社内評価、本人への連絡をどう追うか。候補者と応募を区別する記入例を使い、Excelの継続、採用管理システム、追加連携を比較。通知と閲覧権限も確かめられます。
文章は自然でも、宛先が違う。AIエージェントに任せるとき人が止める場面
返信の文章が自然でも、宛先や契約条件が違えば送信を止めます。問い合わせの例から、人が判断する場所、送信前の承認、結果が不明なときの調査、誤送信後の対応までを具体的に考えられます。